MLPE 스터디 2주차 - Ch4.1 더 해 보기: EDA 막대그래프 position fill과 stack 비교
EDA run의 막대그래프 인자 position="fill"을 "stack"으로 바꿔 run을 하나 더 만들고, 두 그래프가 무엇을 보여 주는지 비교한다.
1. 무엇을 바꾸나
책의 EDA 셀은 범주형 컬럼 8개마다 막대그래프를 그린다. 막대 하나가 컬럼의 값 하나(예: Workclass의 Private)이고, 막대 안은 소득 구간 Target(<=50K, >50K)별 색으로 나뉜다. geom_bar의 position 인자가 두 색을 어떻게 쌓을지 정한다.
position | 막대 길이 | 읽을 수 있는 것 |
|---|---|---|
"fill" (책 코드) | 모든 막대가 1.0으로 같다 | 값마다 고소득(>50K) 비율 |
"stack" (plotnine 기본값) | 그 값의 사람 수만큼 | 값마다 건수와 그 안의 고소득 수 |
2. 실행
JupyterLab에서 책 노트북 옆에 새 노트북 eda_fill_vs_stack.ipynb를 만들고, 4.1절과 같은 chapter-4 커널로 실행했다. 첫 셀은 데이터를 읽고 실험 income-classifier를 고르며, 둘째 셀이 run 두 개를 만든다. 책 셀과 다른 곳은 position을 바꿔 가며 두 번 돈다는 것과, 어느 쪽인지 알 수 있게 position을 파라미터로 기록한다는 것뿐이다.
for position in ["fill", "stack"]:
    out = f"/tmp/eda-{position}"
    os.makedirs(out, exist_ok=True)
    with mlflow.start_run(run_name=f"eda-{position}-{uuid.uuid4().hex[:8]}"):
        mlflow.log_param("position", position)          # Compare 화면에서 두 run 을 구분하는 값
        for i in df.iloc[:, :-1].select_dtypes(include="object").columns:
            plot = (ggplot(df)
                    + geom_bar(aes(x=df[i], fill=df.Target), position=position)
                    + theme_bw() + labs(title=f"Variable {i} ~ Target") + coord_flip())
            plot.save(f"{out}/Variable {i}.png", width=6.4, height=4.8, dpi=100, verbose=False)
        mlflow.log_artifacts(out)                       # 그래프 8장을 run 아티팩트로
책 셀은 루프 안에서 매번 log_artifacts를 불러 같은 파일을 여러 번 올리는데, 여기서는 루프가 끝난 뒤 한 번만 올렸다. 저장 크기를 지정해 PlotnineWarning도 나오지 않는다.
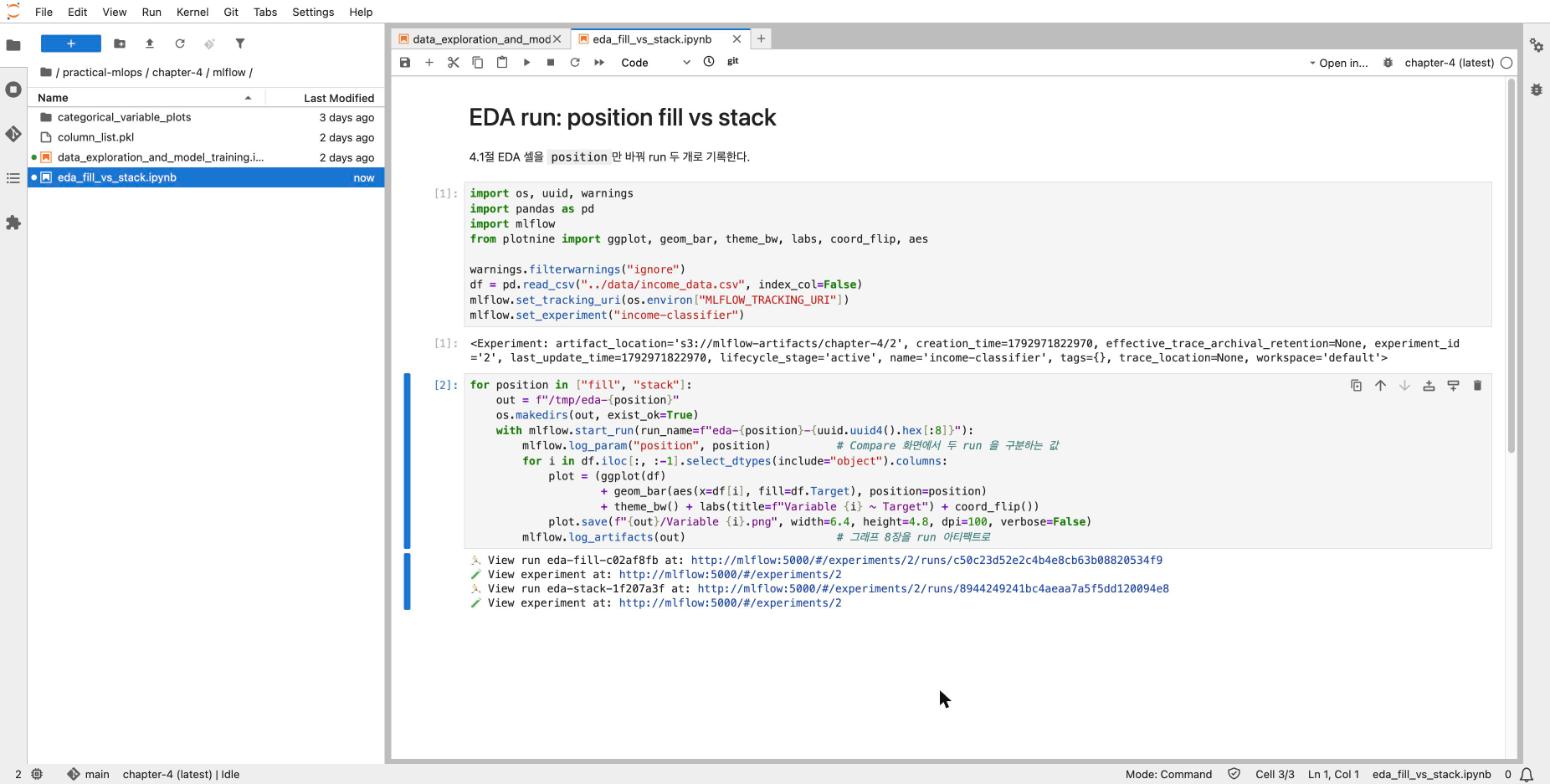
셀이 끝나면 MLflow가 run마다 “View run” 링크를 찍는다. 링크 주소의 mlflow:5000은 클러스터 안 이름이라 브라우저에서는 192.168.0.238:5000으로 바꿔 연다.
| run | position | 아티팩트 |
|---|---|---|
eda-fill-c02af8fb | fill | Variable <컬럼>.png 8장 |
eda-stack-1f207a3f | stack | 같은 이름 8장 |
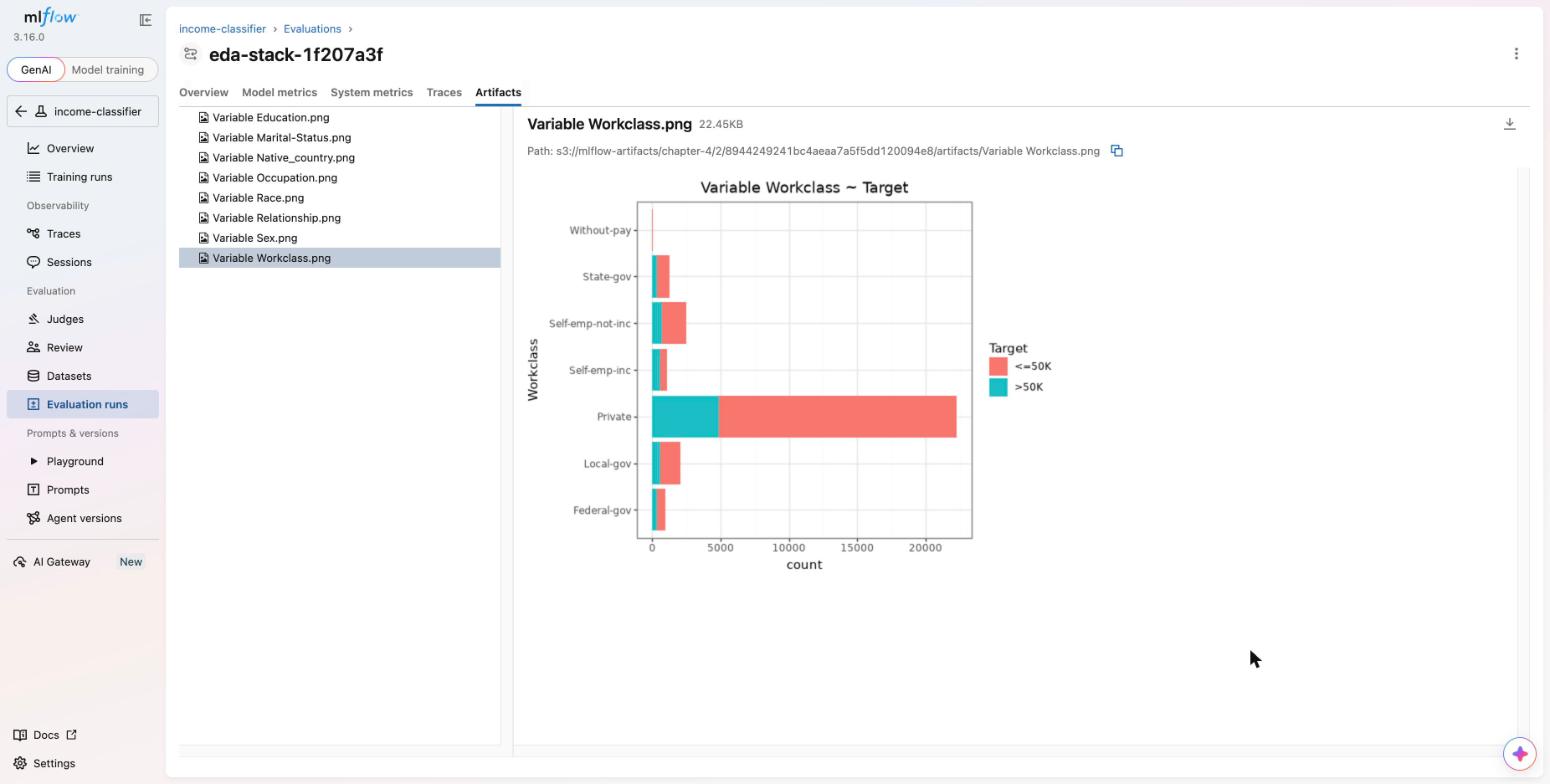
두 run 모두 RustFS mlflow-artifacts/chapter-4/2/<run ID>/artifacts/에 저장되고, MLflow UI의 Artifacts 탭에서 바로 열린다.
3. Workclass로 비교
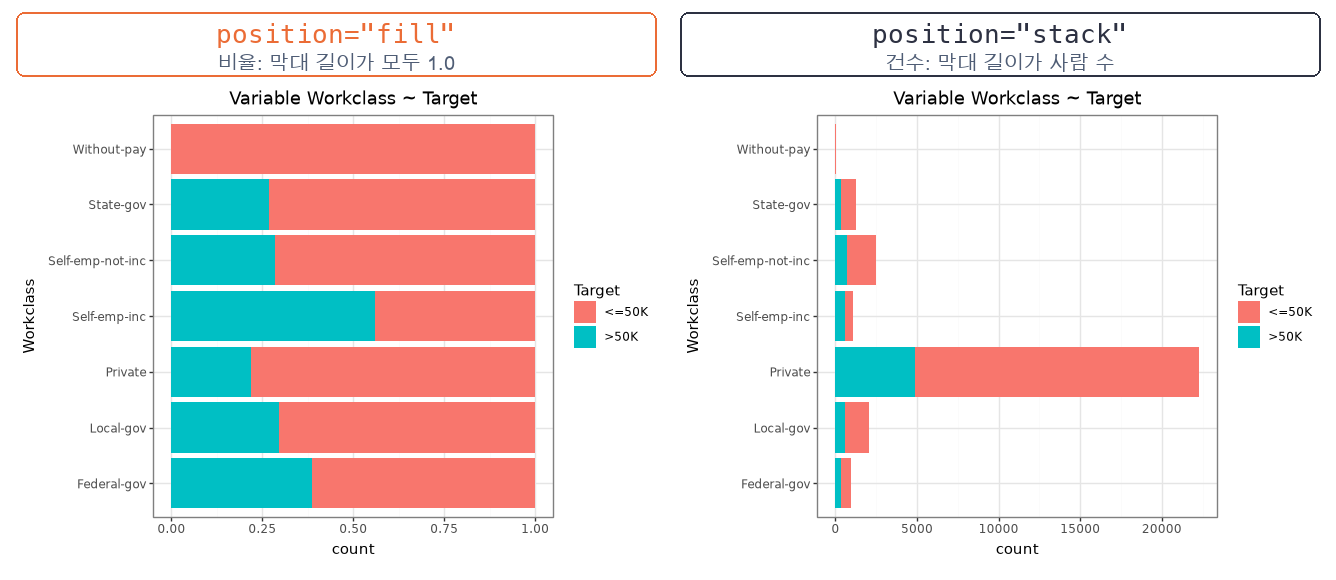
같은 Workclass 컬럼을 두 방식으로 그려 나란히 놓았다. 왼쪽이 position="fill"(책 코드)이고 막대 길이가 모두 같다. 오른쪽이 position="stack"이고 막대가 사람 수만큼 길다.
| Workclass | 사람 수 | >50K 비율 |
|---|---|---|
| Private | 22,286 | 21.9% |
| Self-emp-not-inc | 2,499 | 28.6% |
| Local-gov | 2,067 | 29.5% |
| State-gov | 1,279 | 26.9% |
| Self-emp-inc | 1,074 | 55.9% |
| Federal-gov | 943 | 38.7% |
| Without-pay | 14 | 0.0% |
fill에서 보이는 것은 “어느 값이 고소득일 확률이 높은가"다. Self-emp-inc(법인 자영업자)가 절반 넘게 고소득이라는 점이 바로 눈에 띈다. 모델 입장에서는 Workclass가 Target을 가르는 데 쓸모 있는 피처라는 신호다.
stack에서 보이는 것은 “데이터가 어디에 몰려 있나"다. 전체 30,162명 중 74%가 Private이고, 나머지 값은 막대가 짧아 그 안의 파란 구간 비율을 눈으로 비교하기 어렵다. Self-emp-inc의 55.9%와 State-gov의 26.9% 차이는 stack 그림만으로는 거의 읽히지 않는다.
4. Native_country에서는 차이가 더 크다
값이 41개이고 한쪽에 극단적으로 몰린 컬럼에서는 stack이 사실상 쓸모가 없다. 이번에도 왼쪽이 fill, 오른쪽이 stack이다.
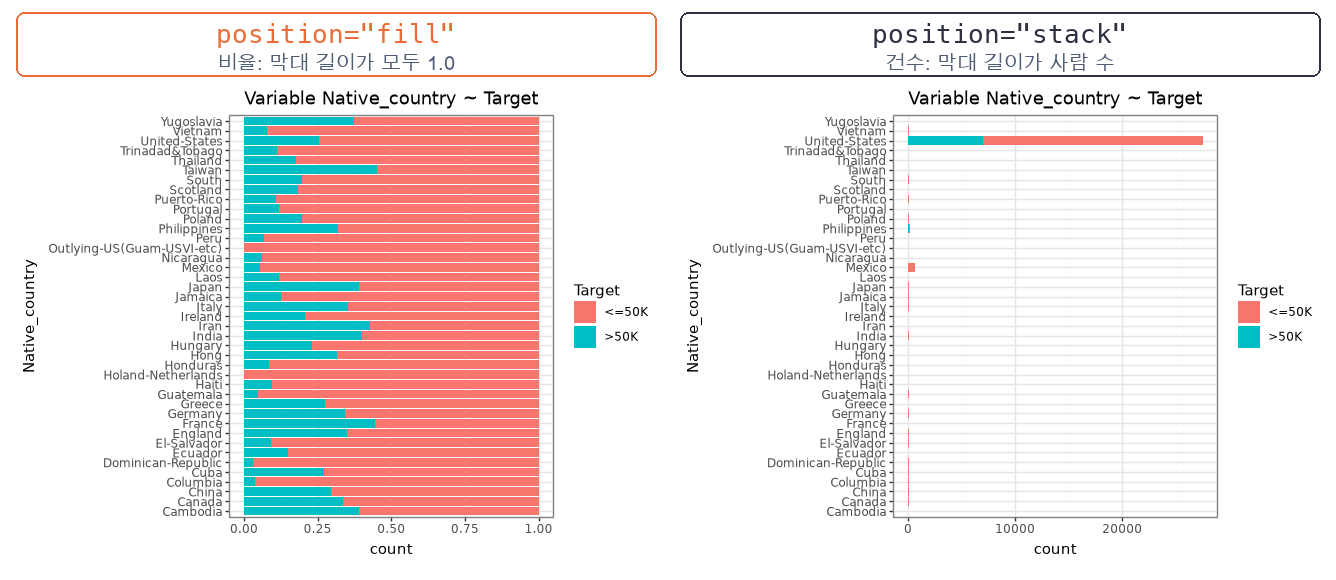
United-States가 27,504명(91%)이고 Mexico 610명, Philippines 188명 순이며, 20명이 안 되는 국가가 11개다. stack에서는 미국 막대 하나만 보이고, fill에서는 41개 국가의 비율이 모두 보인다.
다만 fill에도 함정이 있다. 표본 크기가 사라진다. 14명뿐인 Workclass Without-pay가 22,286명인 Private와 같은 길이로 그려지고, 몇 명 안 되는 국가가 0%나 높은 비율로 튀어도 그림만으로는 우연인지 구분할 수 없다. 그래서 fill 그래프를 볼 때는 셀 출력의 value_counts()(건수)를 같이 봐야 한다.
5. 정리
| 질문 | 맞는 그래프 |
|---|---|
| 이 값이면 고소득일 확률이 높은가 (피처의 예측력) | fill |
| 데이터가 어느 값에 몰려 있나 (불균형, 희소 범주) | stack |
| 비율이 믿을 만한가 | fill + 건수 |
책이 EDA에 fill을 쓴 이유는 이 단계의 목적이 “어떤 컬럼이 Target과 관련 있나"를 보는 것이기 때문이다. stack은 Native_country처럼 희소 범주가 많은 컬럼을 찾아 묶거나 버릴지 정할 때 쓸모가 있다.
MLflow 쪽에서는 코드 한 줄만 바꾼 실행을 같은 실험 아래 별도 run으로 남겼다. position 파라미터로 두 run이 구분되고, Artifacts 탭에서 같은 이름의 그래프를 열어 나란히 비교할 수 있다. 설정을 바꾼 실행 결과를 지우지 않고 쌓아 두는 것이 실험 추적 도구가 하는 일이다.