MLPE 스터디 1주차 - Ch3. MLOps를 위한 k8s 기반 아키텍처
Machine Learning Platform Engineering 3장은 Docker, Kubernetes, CI/CD, 모니터링만 다룹니다. 앞 글에서 MLOps를 루프로 바라보는 관점을 제시하였고 이번에는 그 루프가 올라갈 플랫폼에 대해서 학습합니다. 기존에 홈랩 환경이 구축되어 있어서 별도 kind를 사용하지는 않았습니다.
1. 전체 흐름
- 개발자가
main브랜치에 push 한다. app/**이하의 파일이 바뀌면 GitHub Actions의build-push.yml이 트리거된다.- buildx가 amd64와 arm64 이미지를 함께 빌드한다.
- 빌드한 이미지를 private Docker Hub에
0.1.N과latest태그로 push 한다. - 같은 워크플로가
values.yaml의 이미지 태그와Chart.yaml의 version을 올려[skip ci]커밋으로 저장소에 push 한다. 이 커밋은app/**밖이라 워크플로를 다시 트리거하지 않는다. - 홈랩 Argo CD가 웹훅 없이 약 2~3분마다 저장소
main을 polling 해 변경을 감지한다. - Argo CD가 Helm 차트를 렌더링해 홈랩 클러스터의
funny네임스페이스에 apply 한다. - 파드는
imagePullSecret으로 Docker Hub에서 새 이미지를 pull 한다.
점선(6 ~ 8)은 클러스터 쪽에서 당겨 오는 구간이다. CI는 Git의 차트 버전까지 올리므로 Argo CD는 레지스트리를 볼 필요 없이 Git만 보면 된다.
2. 저장소 구조
3. 홈랩 클러스터
책은 로컬 단일 노드 클러스터를 쓰지만 실습은 이미 운영 중인 온프레미스 홈랩 클러스터에서 한다.
| 항목 | 책 | 홈랩 |
|---|---|---|
| Kubernetes | v1.29.14 | kubeadm v1.36.5, 노드 3대 |
| 노드 | 단일 노드 | control-plane rocky-linux(amd64), worker1-gpu(amd64, GPU), worker2-arm64(arm64) |
| CNI | 명시 없음 | Cilium v1.20.2 (kube-proxy replacement) |
| 외부 노출 | NodePort | Cilium LB-IPAM + L2 announcement, 풀 192.168.0.230 ~ 250 |
| Argo CD | 직접 설치 | v3.5.3 (helm 설치, 홈랩 저장소에서 관리) |
| Helm | v3 | v4.2.2 |
책과의 차이점
- 노드 아키텍처가 섞여 있다.
- amd64 노드와 Raspberry Pi arm64 노드가 같이 있어 이미지를 반드시 멀티아키로 빌드해야 한다.
type: LoadBalancer가 바로 동작한다.- Cilium LB-IPAM이 LAN 대역에서 IP를 할당하므로 NodePort 매핑이 필요 없다.
LoadBalancer IP 사용 가능한 이유 (참고)
hello-jokerService가192.168.0.235:8083으로 접속 가능한 것은 현재 홈랩에 Cilium을 설치해 두었기 때문이다. 클라우드처럼 외부 로드밸런서를 두지 않고 클러스터 노드가 직접 그 IP를 대신 받아 준다.
# 1) LB-IPAM: LoadBalancer Service에 줄 IP 풀
spec:
  blocks:
    - start: 192.168.0.230
      stop: 192.168.0.250
---
# 2) L2 announcement: 그 IP를 LAN에 ARP로 알릴 노드와 인터페이스
spec:
  loadBalancerIPs: true
  interfaces: ["^eno1$", "^eth0$"]
  nodeSelector:
    matchExpressions:
      - key: node-role.kubernetes.io/control-plane
        operator: DoesNotExist        # worker 노드만 응답
type: LoadBalancerService가 생기면 LB-IPAM이lan-pool(192.168.0.230 ~ 250)에서 빈 IP 하나(192.168.0.235)를 골라EXTERNAL-IP로 붙인다.- L2 announcement가 worker 노드 중 하나를 리더로 정하고 그 노드가 LAN에서 “
192.168.0.235는 내 MAC 주소"라고 ARP에 응답한다. - LAN의 다른 기기(개발 PC 등)는 이 ARP 응답을 보고 해당 노드로 패킷을 보낸다. 별도 라우팅 설정 없이 같은 서브넷 통신으로 끝난다.
- 패킷을 받은 노드에서 Cilium(eBPF, kube-proxy replacement)이
hello-joker파드 3개 중 하나로 넘긴다.
공유기가 같은 IP를 다른 기기에 나눠 주면 ARP 응답이 충돌해 연결이 끊기기 때문에 192.168.0.230 ~ 250은 공유기 DHCP 할당 범위에서 빼 두고 클러스터 전용으로 쓴다. (공유기 설정 페이지에서 설정)
4. CI로 버전관리하기
이미지 태그를 사람이 values.yaml에 적는 방식은 누락되기 쉽다. 또한 GitOps로 가려면 어차피 CI가 이미지를 올려야 한다.
그래서 깃헙액션 워크플로 하나가 이미지와 차트 버전을 동시에 올린다.
on:
  push:
    branches: [main]
    paths:
      - "app/**"                  # 차트 범프 커밋은 이 경로 밖이라 재트리거되지 않는다
      - ".github/workflows/build-push.yml"

permissions:
  contents: write                 # 차트 버전 커밋을 푸시하려면 필요

steps:
  - name: Compute version (Chart.yaml version 의 patch +1)
    run: |
      CURRENT=$(yq '.version' "$CHART_DIR/Chart.yaml")
      VERSION=$(echo "$CURRENT" | awk -F. '{printf "%d.%d.%d", $1, $2, $3+1}')

  - name: Build and push
    uses: docker/build-push-action@v7
    with:
      platforms: linux/amd64,linux/arm64

  - name: Bump Helm chart
    run: |
      yq -i ".image.tag = \"$VERSION\"" "$CHART_DIR/values.yaml"
      yq -i ".version = \"$VERSION\" | .appVersion = \"$VERSION\"" "$CHART_DIR/Chart.yaml"

  - name: Commit and push chart update
    run: git commit -m "ci: bump hello-joker chart to $VERSION [skip ci]"
버전 계산 방식
버전은 Chart.yaml의 version을 읽어 patch를 +1 한 값이다. 이 값 하나를 이미지 태그, 차트 version, appVersion에 똑같이 써서 이미지 태그 = 차트 version = appVersion이 된다.
버전의 단일 진실 공급원은 Git의 Chart.yaml이다. github.run_number는 워크플로 파일명이 바뀌면 1로 리셋되므로 쓰지 않는다. Git 기준이라 워크플로 이름이나 파일이 바뀌어도 버전은 단조 증가한다.
멀티아키가 필요한 이유
홈랩에는 amd64 노드와 Raspberry Pi arm64 노드가 한 클러스터에 섞여 있어서 platforms: linux/amd64,linux/arm64를 지정한다. 한쪽만 빌드하면 다른 아키텍처 노드에 스케줄된 파드가 exec format error로 죽는다.
5. Argo CD: app-of-apps와 polling
5.1 루트 Application이 저장소를 감시한다
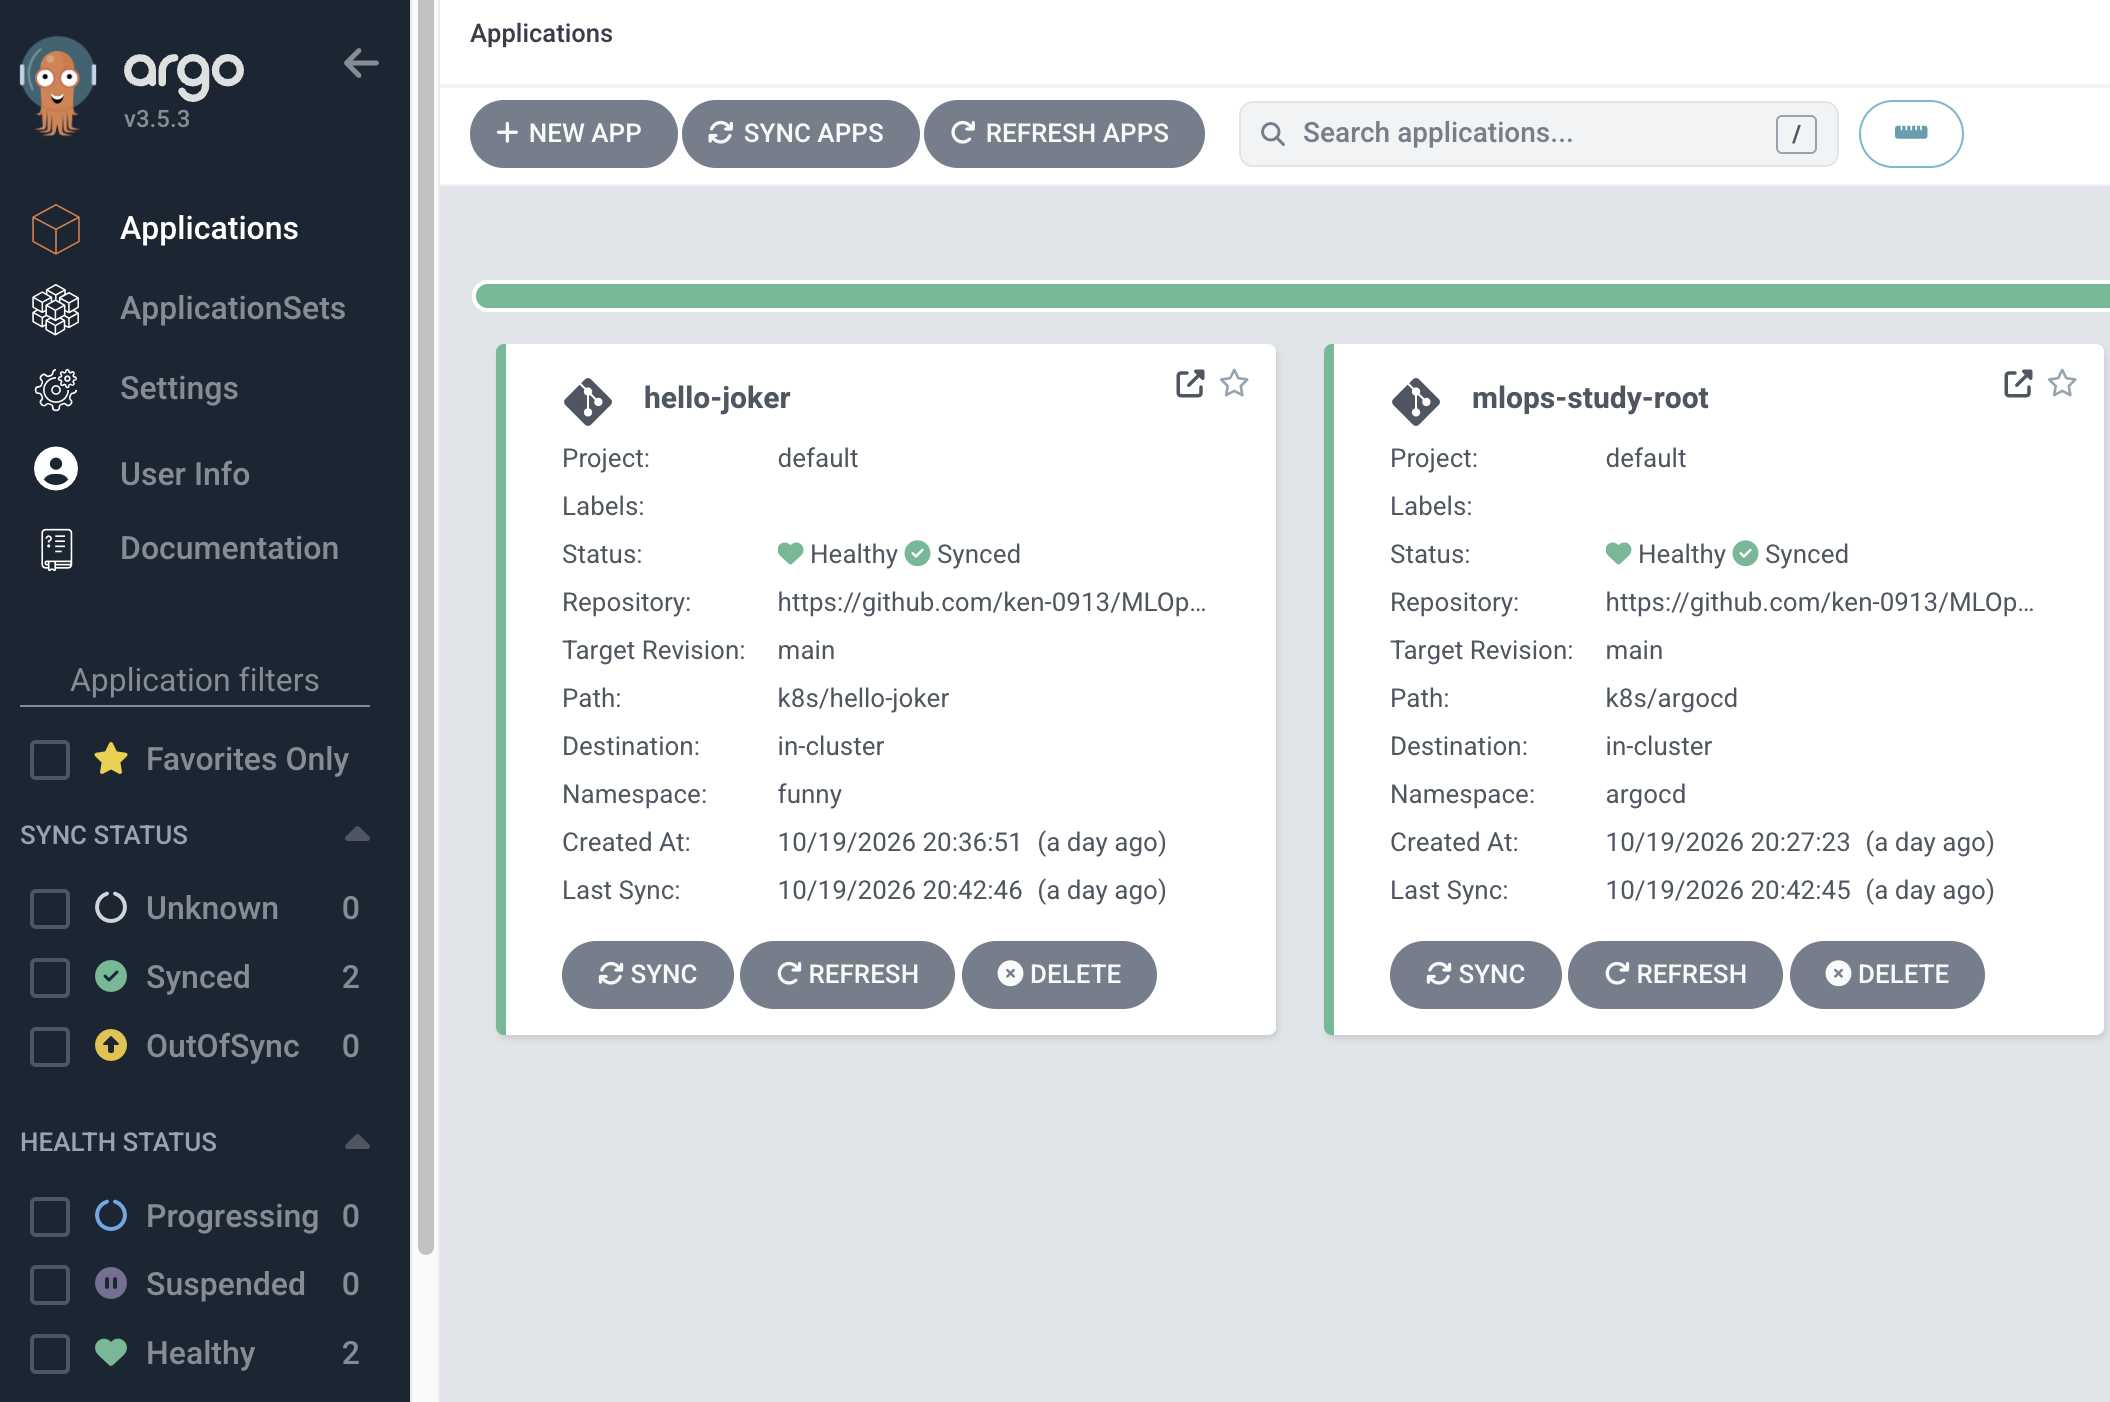
이미 홈랩 Argo CD가 설치되어 있었다. 이 저장소의 Application을 직접 kubectl apply 하지 않고 별도로 관리하는 홈랩 저장소의 루트 Application이 현재 실습을 진행 중인 저장소를 가리키게 했다(app-of-apps).
- 루트
mlops-study-root가(별도 홈랩 저장소) 이 저장소main의k8s/argocd디렉터리를 sync 한다. - 그 안의
hello-joker-app.yaml이 하위 Application으로 생긴다. - 하위 Application이
k8s/hello-joker차트를funny네임스페이스에 배포한다.
spec:
  source:
    repoURL: https://github.com/ken-0913/MLOps-study.git
    targetRevision: main
    path: k8s/hello-joker
    helm:
      releaseName: hello-joker
      valuesObject:
        service:
          type: LoadBalancer   # Cilium LB-IPAM 이 192.168.0.230 ~ 250 에서 IP 할당
  destination:
    namespace: funny
  syncPolicy:
    automated:
      prune: true        # Git에서 제거된 리소스 삭제
      selfHeal: true     # 클러스터 드리프트 자동 복구
    syncOptions:
      - CreateNamespace=true
5.2 설계에서 정한 것들
웹훅 대신 polling을 쓴다.
- 홈랩에는 GitHub 웹훅을 받을 공개 주소가 없다.
argocd-cm의timeout.reconciliation기본값(120s)에 jitter(60s)가 붙어, push 후 반영까지 최대 약 3분이 걸린다.
차트 기본값은 건드리지 않는다.
- 차트의
service.type은NodePort로 두고 Application의helm.valuesObject로LoadBalancer를 덮어쓴다. 환경별 차이는 Application에만 둔다.
루트에는 cascade finalizer를 달지 않는다.
- 루트를 지워도 하위 Application과 워크로드는 남는다. 홈랩 저장소 쪽 작업이 이 저장소의 배포를 실수로 날리지 않게 하기 위함이다.
k8s/argocd/에는 Application 매니페스트만 둔다. 이 디렉터리의 매니페스트는 전부 argocd 네임스페이스에 적용되고 prune 된다. 대신 새 Application은 이 디렉터리에 파일을 추가해 push 하는 것만으로 생긴다.
5.3 확인
kubectl -n argocd get applications
kubectl -n funny get svc,pods
curl -s http://192.168.0.235:8083/ | jq{ "random_joke": "Why did the programmer quit his job? Because he didn't get arrays." }6. 클러스터에 넣는 토큰은 최소 권한으로 한다.
저장소와 이미지가 모두 private이라 자격 증명 두 개가 필요했다. 이때 어떤 토큰을 넣을지가 별도 결정이 됐다.
| Secret | 용도 | 토큰 |
|---|---|---|
argocd/repo-mlops-study | Argo CD가 private 저장소 clone | fine-grained PAT. MLOps-study 저장소 하나만, Contents: Read-only |
funny/dockerhub | 파드가 private 이미지 pull | Docker Hub Read-only Access Token |
gh auth token은 쓰지 않는다. 계정 전체 쓰기 권한이라 클러스터 Secret에 들어가면 노출 범위가 지나치게 넓다.
토큰은 아래와 같이 프롬프트로 받아 화면과 셸 기록에 남지 않게 한다.
read -rs "GH_TOKEN?GitHub token: "
kubectl -n argocd create secret generic repo-mlops-study \
  --from-literal=type=git \
  --from-literal=url=https://github.com/ken-0913/MLOps-study.git \
  --from-literal=username=ken-0913 \
  --from-literal=password="${GH_TOKEN}"
kubectl -n argocd label secret repo-mlops-study argocd.argoproj.io/secret-type=repository
unset GH_TOKEN
pull secret이 없으면 파드가 ImagePullBackOff에 머문다. Secret을 만들면 별도 조치 없이 자동 복구된다.
7. Prometheus·Grafana로 hello-joker 관측하기
홈랩에는 kube-prometheus-stack(Prometheus, Grafana)이 이미 설치되어 있다. 책처럼 모니터링 스택을 새로 설치하지 않고 기존 스택에 hello-joker를 수집 대상으로 붙이는 것만 한다.
작업은 두 저장소에 나뉜다. 앱이 지표를 내보내는 일은 MLOps-study가, 그 지표를 수집하고 보여 주는 일은 홈랩 저장소(~/k8s/observability)가 맡는다.
| 위치 | 변경 | 적용 방식 |
|---|---|---|
MLOps-study app/ | /metrics 노출 | push → CI 빌드(0.1.5) → Argo CD 배포 |
홈랩 05-integrations/hello-joker-monitor.yaml | ServiceMonitor | kubectl apply -f |
홈랩 05-integrations/dashboards/hello-joker.json | Grafana 대시보드 | ConfigMap으로 적용 |
7.1 앱이 /metrics를 노출한다
배포된 hello-joker에 /metrics를 요청하면 404가 돌아왔다. 수집할 지표가 없으면 cAdvisor가 주는 CPU·메모리 외에는 볼 것이 없다.
prometheus-fastapi-instrumentator를 붙이면 한 줄로 요청 수, 지연, 상태 코드 지표가 생긴다.
from fastapi import FastAPI
from prometheus_fastapi_instrumentator import Instrumentator
import pyjokes

app = FastAPI()

# /metrics 노출: 요청 수, 지연, 상태 코드 (ServiceMonitor 가 수집)
Instrumentator().instrument(app).expose(app, include_in_schema=False)

@app.get("/")
async def root():
    random_joke = pyjokes.get_joke("en","neutral")
return {"random_joke": random_joke}requirements.txt에는 prometheus-client==0.26.0과 prometheus-fastapi-instrumentator==6.1.0을 추가한다. 7.x는 starlette 0.30 이상을 요구해서 현재 고정한 fastapi 0.95.2(starlette 0.27)와 맞지 않는다.
7.2 ServiceMonitor로 수집 대상을 등록한다
Prometheus Operator 환경에서는 Prometheus 설정 파일을 직접 고치지 않는다. ServiceMonitor라는 CRD를 만들면 Operator가 그 내용을 scrape 설정으로 바꿔 준다.
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: hello-joker
  namespace: funny
spec:
  selector:
    matchLabels:
      app.kubernetes.io/name: hello-joker
      app.kubernetes.io/instance: hello-joker
  endpoints:
    - port: http          # Service 포트 이름 (8083)
      path: /metrics
interval: 15skubectl apply -f observability/05-integrations/hello-joker-monitor.yamlselector는 차트가 만든 Service의 라벨을 가리키고 port는 포트 번호가 아니라 Service 포트 이름(http)이다. Prometheus는 이 Service의 Endpoints를 따라가 파드 3개를 각각 수집한다.
별도 라벨 없이 수집되는 이유는 홈랩 Prometheus 설정에 있다. serviceMonitorSelectorNilUsesHelmValues: false와 serviceMonitorNamespaceSelector: {}로 모든 네임스페이스의 ServiceMonitor를 선택하도록 해 두었다. 기본값이면 release: kube-prometheus-stack 라벨이 없는 ServiceMonitor는 무시된다.
7.3 ServiceMonitor를 홈랩 저장소에 둔 이유
홈랩에서는 vLLM, Keycloak, istiod 같은 다른 수집 대상의 ServiceMonitor도 모두 observability/ 아래에서 관리한다. 수집 설정을 모니터링 스택과 같은 곳에 모아 두면 무엇을 수집하는지 한 디렉터리에서 확인할 수 있다.
앱은 /metrics를 노출하기만 하고 수집 설정은 홈랩 저장소가 갖는다. Service 자체는 차트가 만들고 Argo CD가 관리하므로 홈랩 쪽에는 ServiceMonitor만 둔다.
7.4 Grafana 대시보드를 ConfigMap으로 올린다
Grafana 사이드카가 모든 네임스페이스에서 grafana_dashboard=1 라벨이 붙은 ConfigMap을 감시한다. 대시보드 JSON을 ConfigMap으로 만들면 Grafana UI를 거치지 않고 자동으로 로드된다.
f=observability/05-integrations/dashboards/hello-joker.json
kubectl -n monitoring create configmap "dashboard-$(basename $f .json)" --from-file=$f \
  --dry-run=client -o yaml \
  | kubectl label --local -f - grafana_dashboard=1 -o yaml \
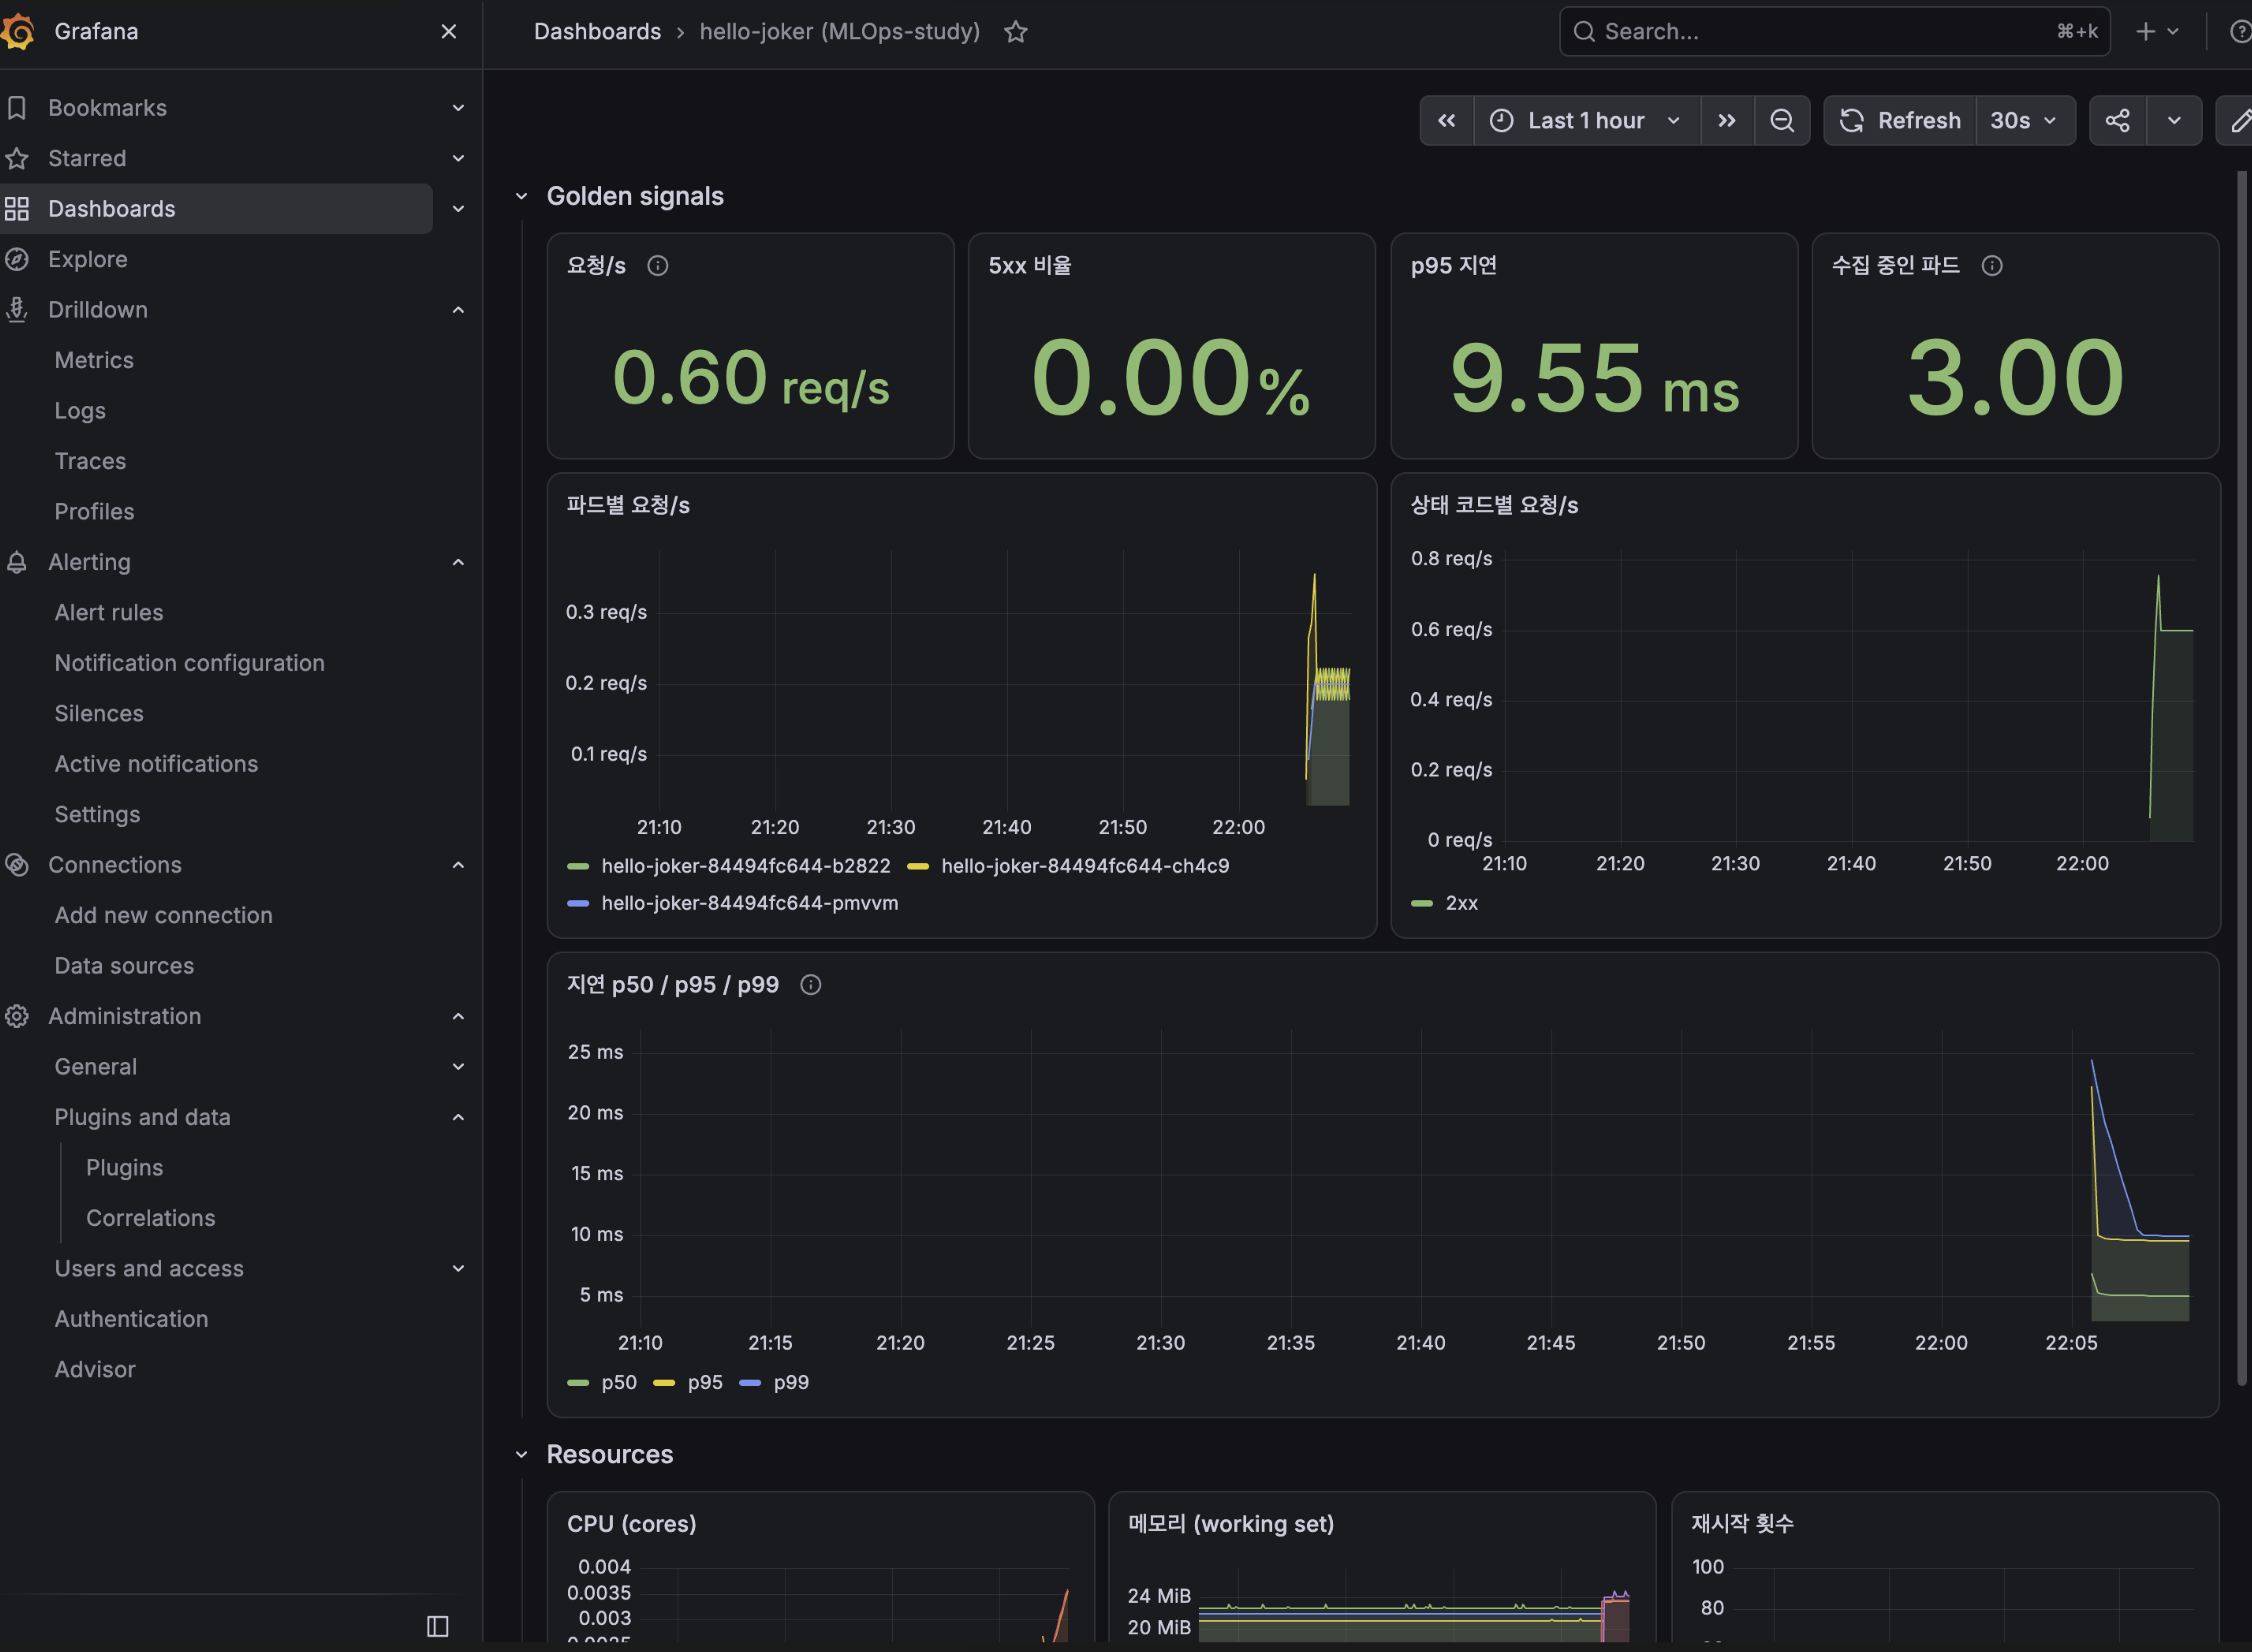
| kubectl apply --server-side -f -대시보드(/d/hello-joker)의 패널과 쿼리는 아래와 같다.
| 패널 | PromQL |
|---|---|
| 요청/s | sum(rate(http_requests_total{namespace="funny", service="hello-joker", handler!="/metrics"}[1m])) |
| 5xx 비율 | 5xx 요청률 ÷ 전체 요청률 (5분) |
| p50 / p95 / p99 지연 | histogram_quantile(0.95, sum by (le) (rate(http_request_duration_highr_seconds_bucket{...}[5m]))) |
| 수집 중인 파드 | sum(up{namespace="funny", service="hello-joker"}) |
| CPU · 메모리 · 재시작 | cAdvisor, kube-state-metrics (container="hello-joker") |
지연에는 http_request_duration_highr_seconds를 쓴다. 라벨이 없는 대신 버킷이 촘촘해서 수십 ms 단위 응답의 분위수가 정확하게 나온다.
7.5 확인
배포가 끝난 뒤 Prometheus에서 수집 상태를 조회하면 새 파드 3개가 모두 up=1이고 2xx 요청이 늘어나며 p95 지연은 약 10ms이다.
kubectl -n monitoring port-forward svc/kube-prometheus-stack-prometheus 9090:9090 &
curl -s --get localhost:9090/api/v1/query \
  --data-urlencode 'query=up{namespace="funny"}'
liveness·readiness probe도 /를 호출하므로 요청 수에는 probe 트래픽(파드당 10초에 2회)이 섞인다. 실제 사용자 요청만 보려면 probe 경로를 /healthz 같은 별도 경로로 분리해야 한다.