LLM 스터디 4주차 - TP/DP 멀티 GPU 서빙 실습 매뉴얼 — Runpod A100 4-GPU
단일 노드에 GPU 4개가 달린 환경(NVLink or PCIe)에서 TP=4, TP=2 × DP=2, DP=4 세 가지 구성으로 vLLM 서빙을 띄우고 속도를 비교하는 실습 순서를 정리한다. 원래는 TP=8까지 포함할 계획이었지만 Runpod 인벤토리 제약으로 현재 4-GPU가 상한이라 같은 4장 안에서 TP와 DP 비중만 조절하는 방식으로 실험을 재구성했다.
TP 비중이 높을수록(왼쪽) GPU끼리 주고받는 통신라인이 많아지고, DP 비중이 높을수록(오른쪽) 통신라인이 줄어들며 완전히 독립된 복제본으로 바뀐다.
멀티 GPU 병렬화, 네 가지 방식
멀티 GPU·멀티 노드 추론에서 쓰는 병렬화 방식은 크게 네 가지다.
- 데이터 병렬화(DP) — 처리량 확장을 위해 GPU와 노드 전반에 모델 인스턴스를 통째로 복제하는 방식이다.
- 텐서 병렬화(TP) — 대형 모델에 적합하며, 레이어를 쪼개 대규모 행렬 연산을 나눠 맡겨 지연 시간을 줄인다.
- 파이프라인 병렬화(PP) — 역시 대규모 모델에 적합하며, 여러 GPU와 노드에 걸쳐 레이어를 단계별로 분할하는 방식으로 작동한다.
- 전문가 병렬화(EP) — Mixture-of-Experts(MoE) 모델의 경우, GPU에 전문가(expert)를 분산시켜 작동한다.
이 실습은 이 중 DP와 TP만 다룬다. 단일 노드(GPU 4장)에 다 들어가는 dense 모델(Qwen3-8B)이라 여러 노드로 걸치는 PP는 필요 없고, MoE 구조가 아니라 EP도 해당하지 않는다. 그래서 남는 선택지는 “레이어를 쪼갤 것이냐(TP), 모델을 통째로 복제할 것이냐(DP)냐"뿐이고, 이 매뉴얼은 그 두 축의 비중을 4장짜리 GPU 안에서 바꿔가며 비교한다.
1. Runpod Pod 준비
- Template: vLLM Verified
- Compute 필터: GPU Type = A100 SXM(PCIe 아님 NVLink 확보), GPU Count = 4
- Storage: 모델 크기 고려해 컨테이너 디스크 여유 있게(7B~14B급이면 50GB+)
8장짜리 재고 찾기도 힘들고 가격도 만만치 않아서 4장으로만 실습진행, 아래 3장파트의 명령에서 --tensor-parallel-size 8 조합만 추가하면 된다.
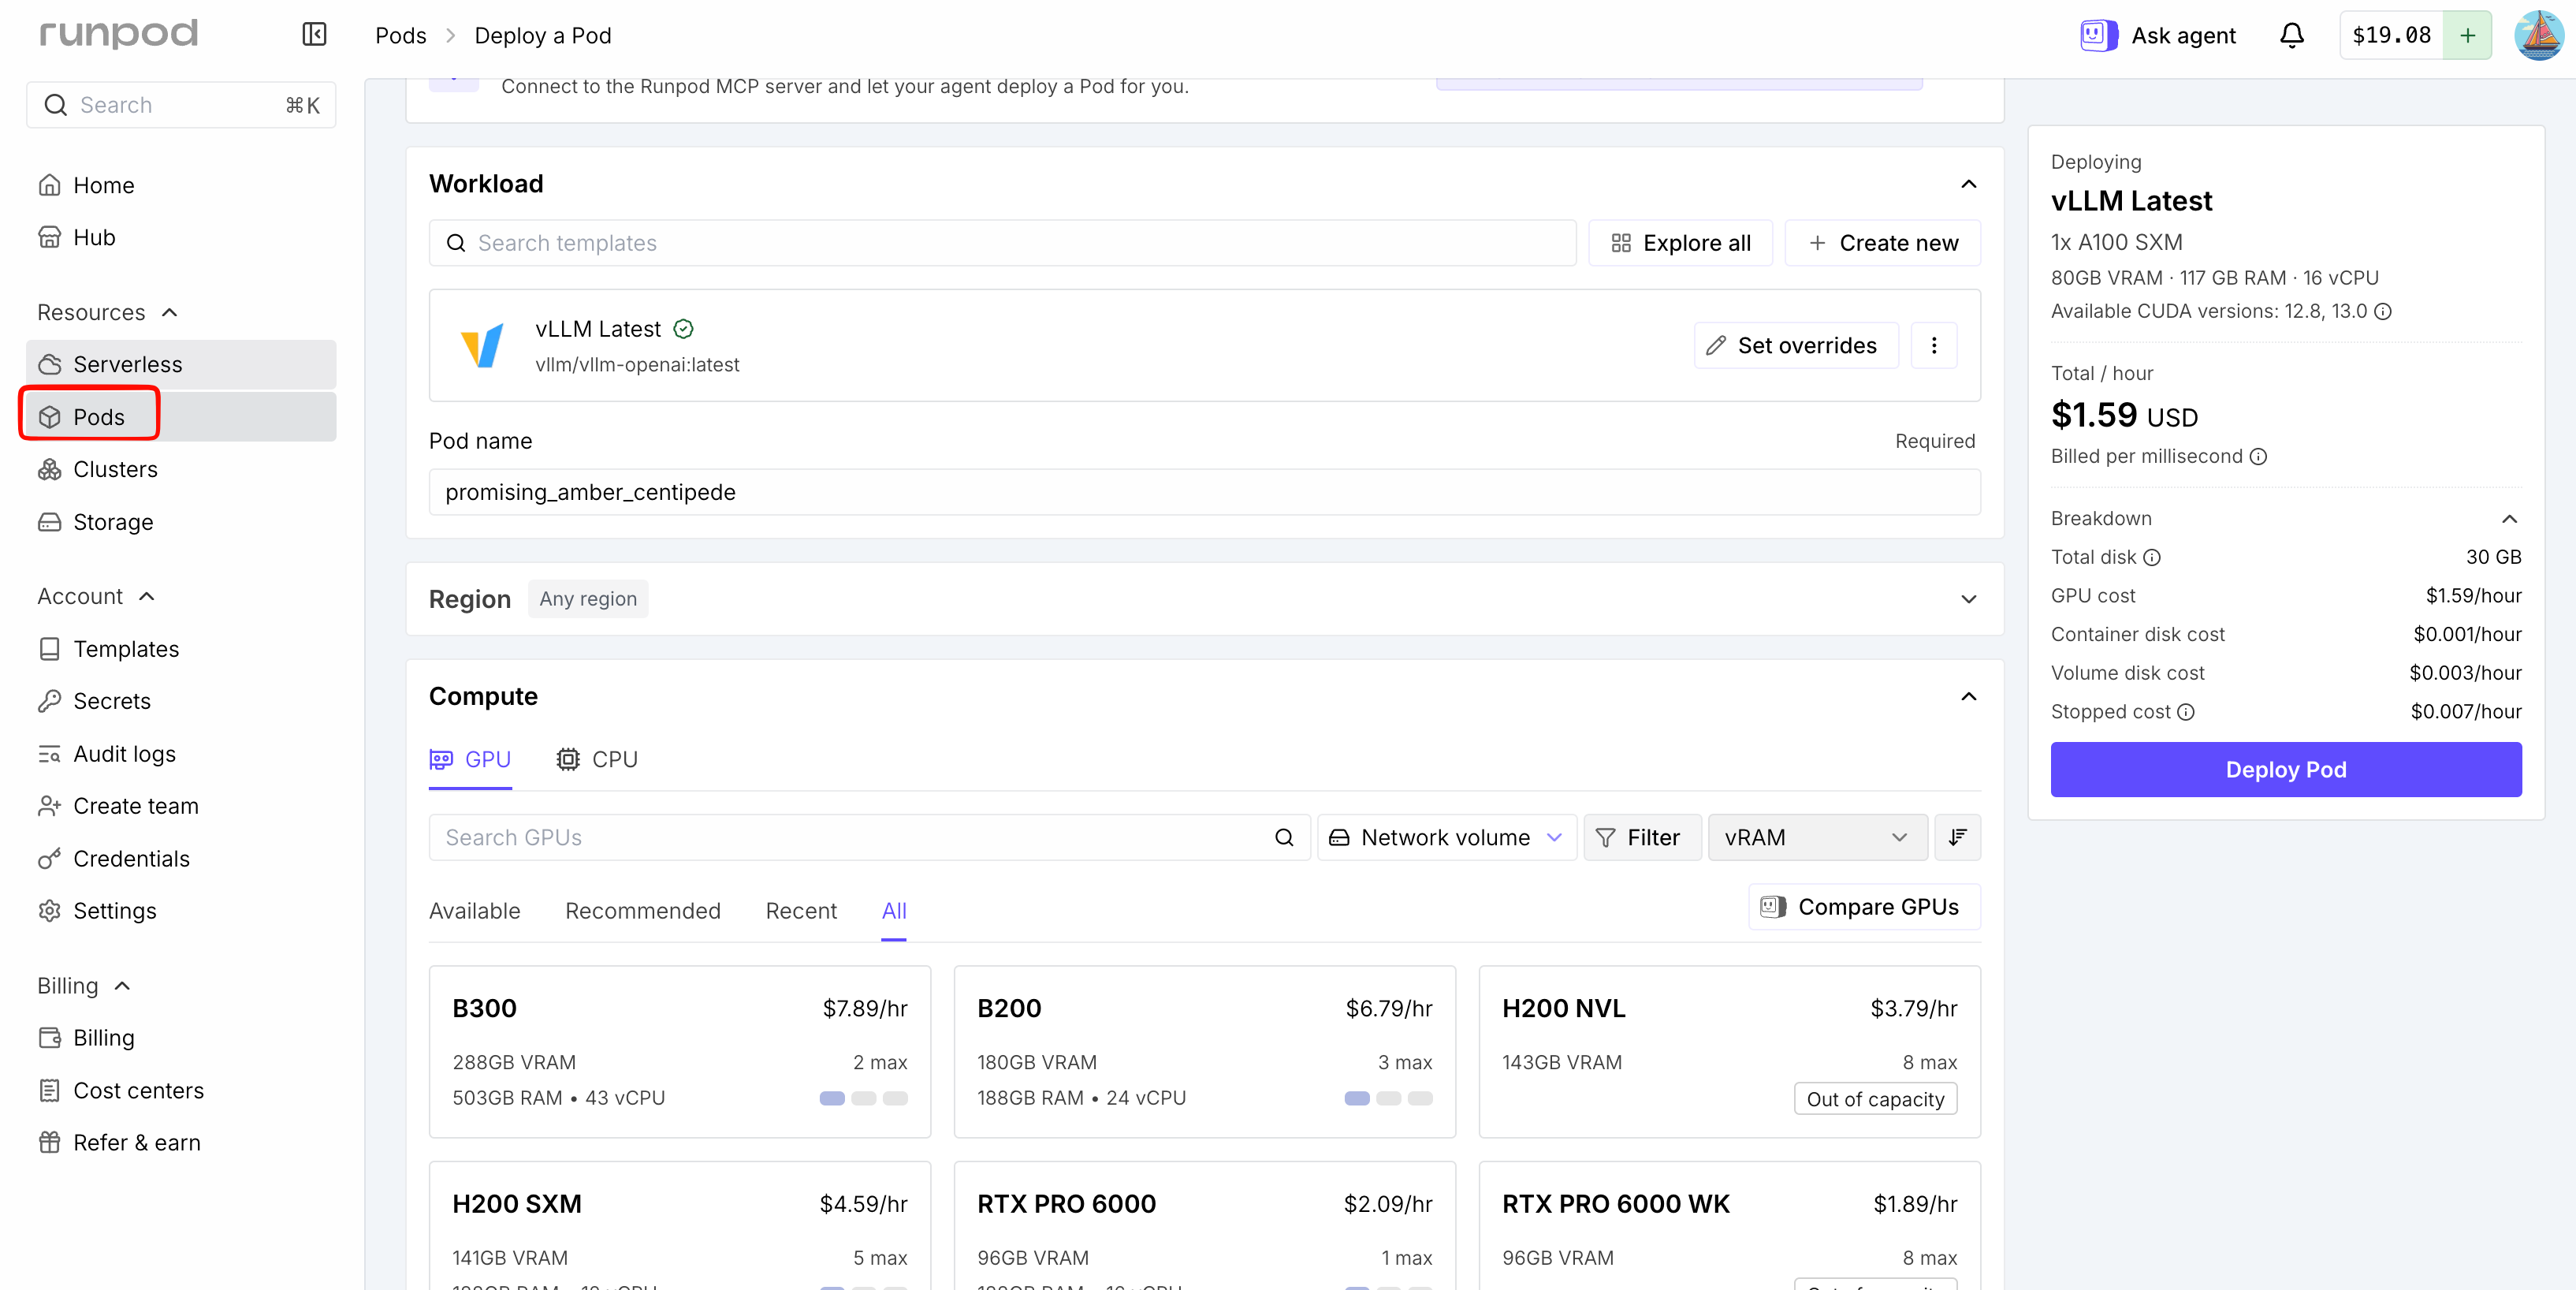
- 가입 충전 후 Pods 선택, GPU 선택
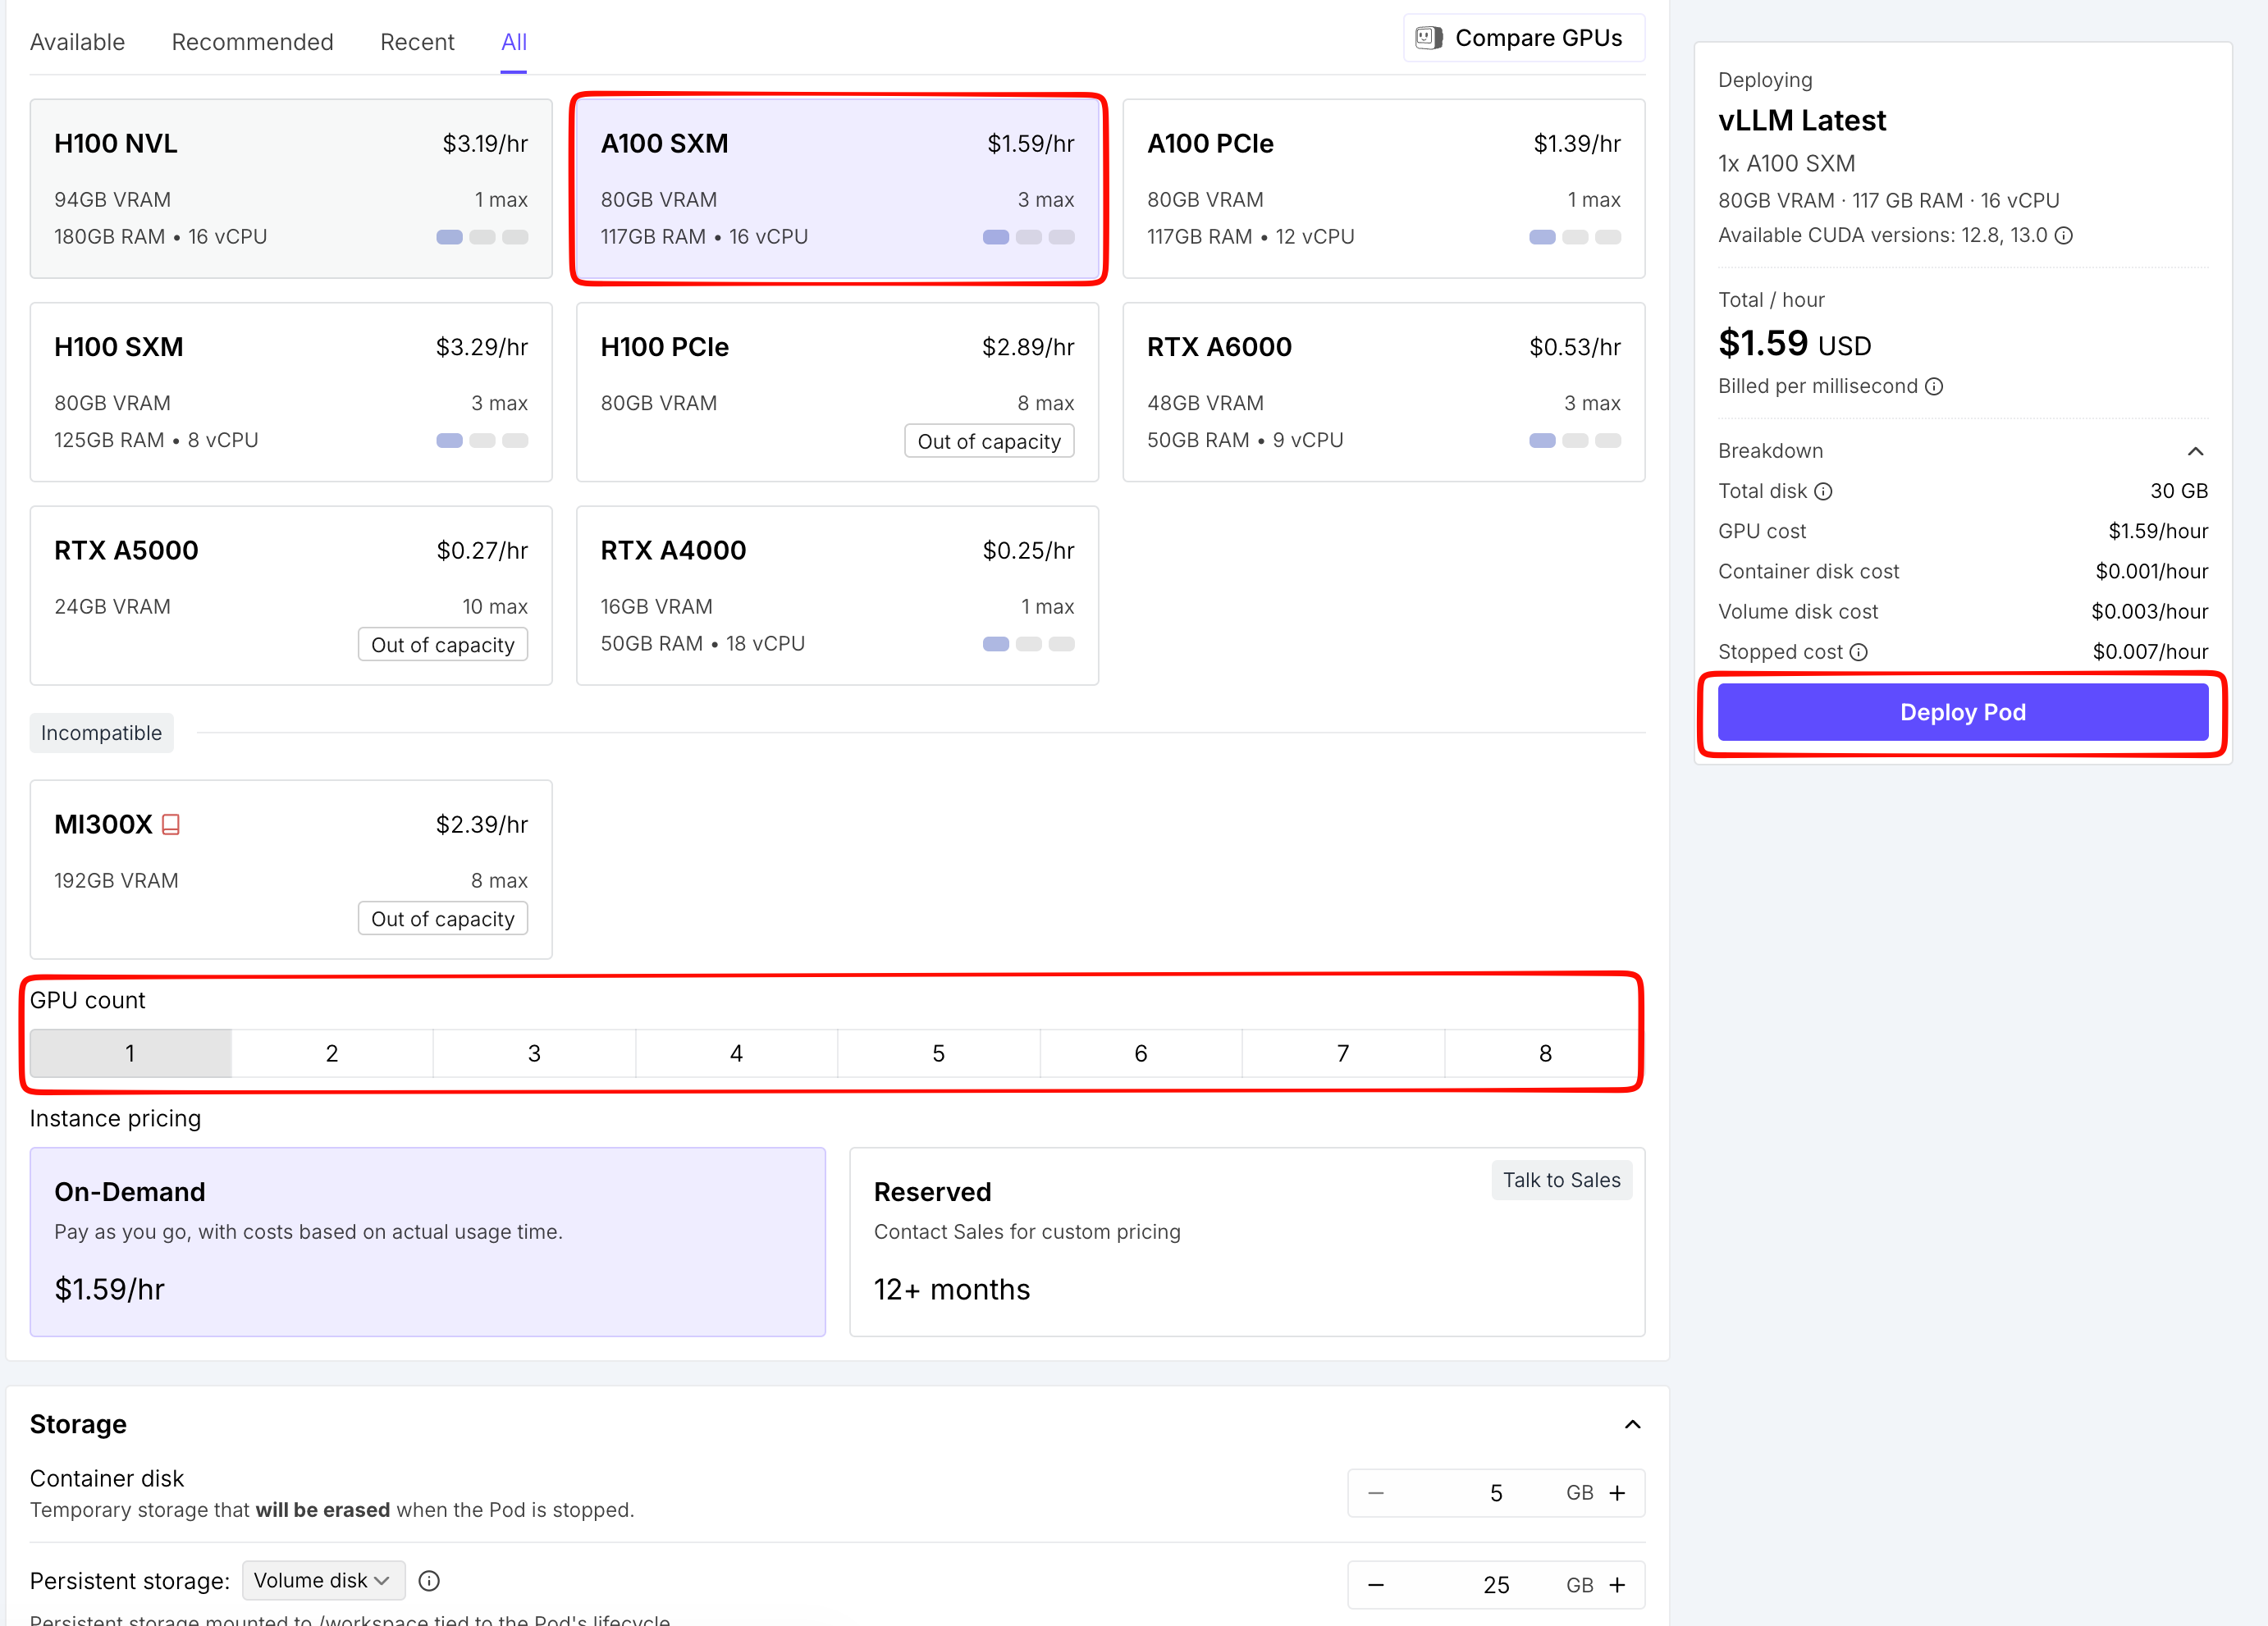
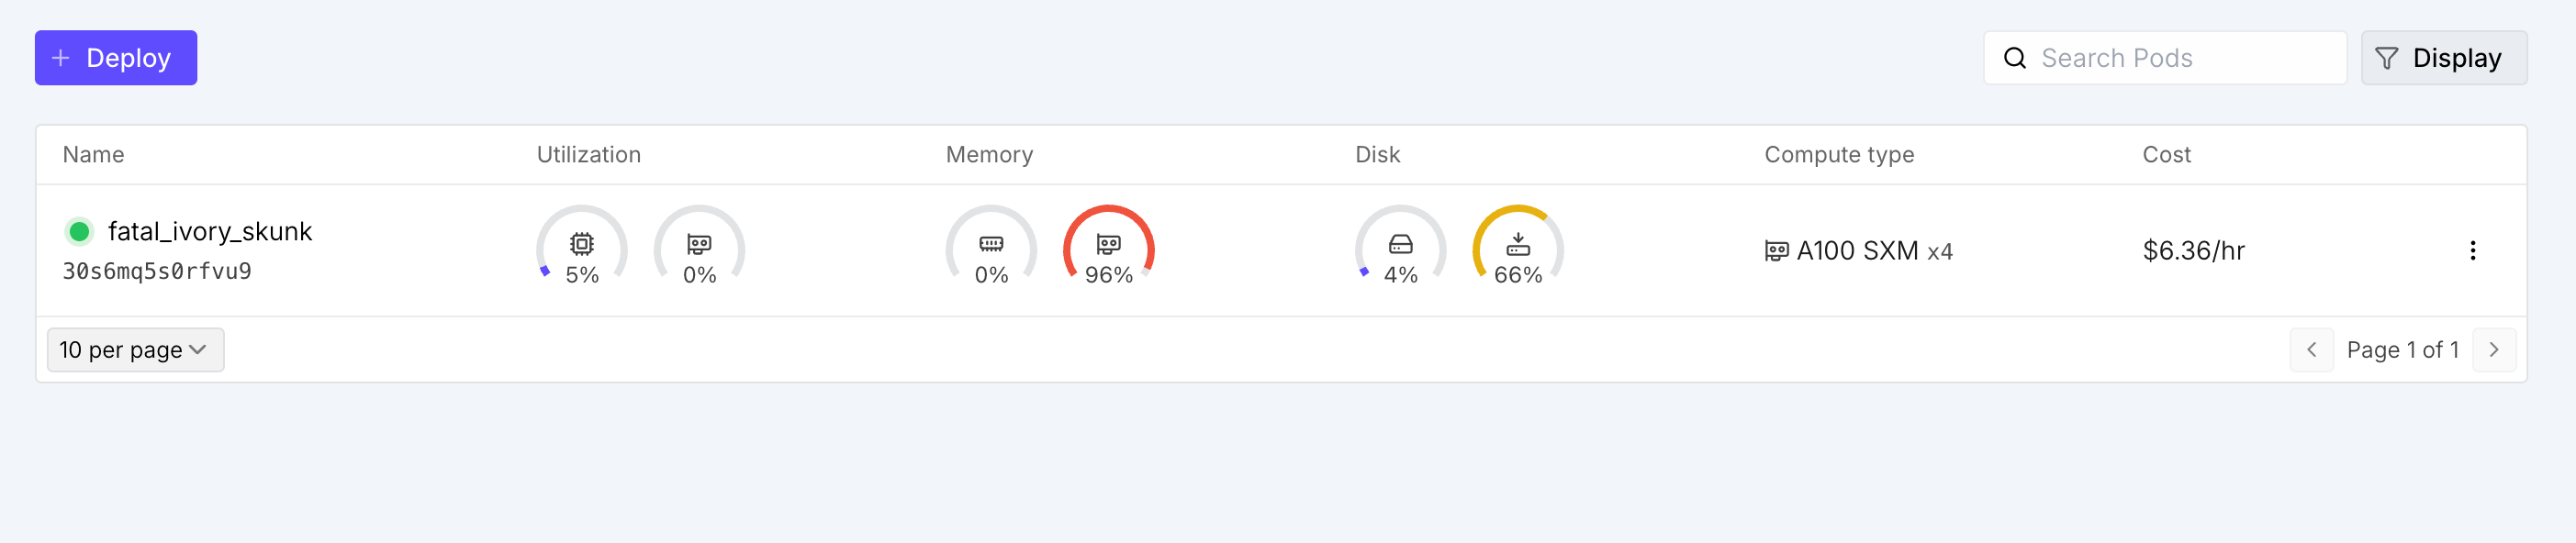
- A100 SXM 과 GPU count를 4장 선택 후 Deploy Pod 클릭
- 배포된 상태를 확인 할 수 있다. Compute type에서 A100 SXM x4인것을 확인. 코스트 시간당 $6.36/hr………………………
- 시크릿을 설정하자. Secrets -> Create secret으로 생성하자. 아래 명령어로 랜덤 숫자를 만들어 추가하자.
openssl rand -hex 32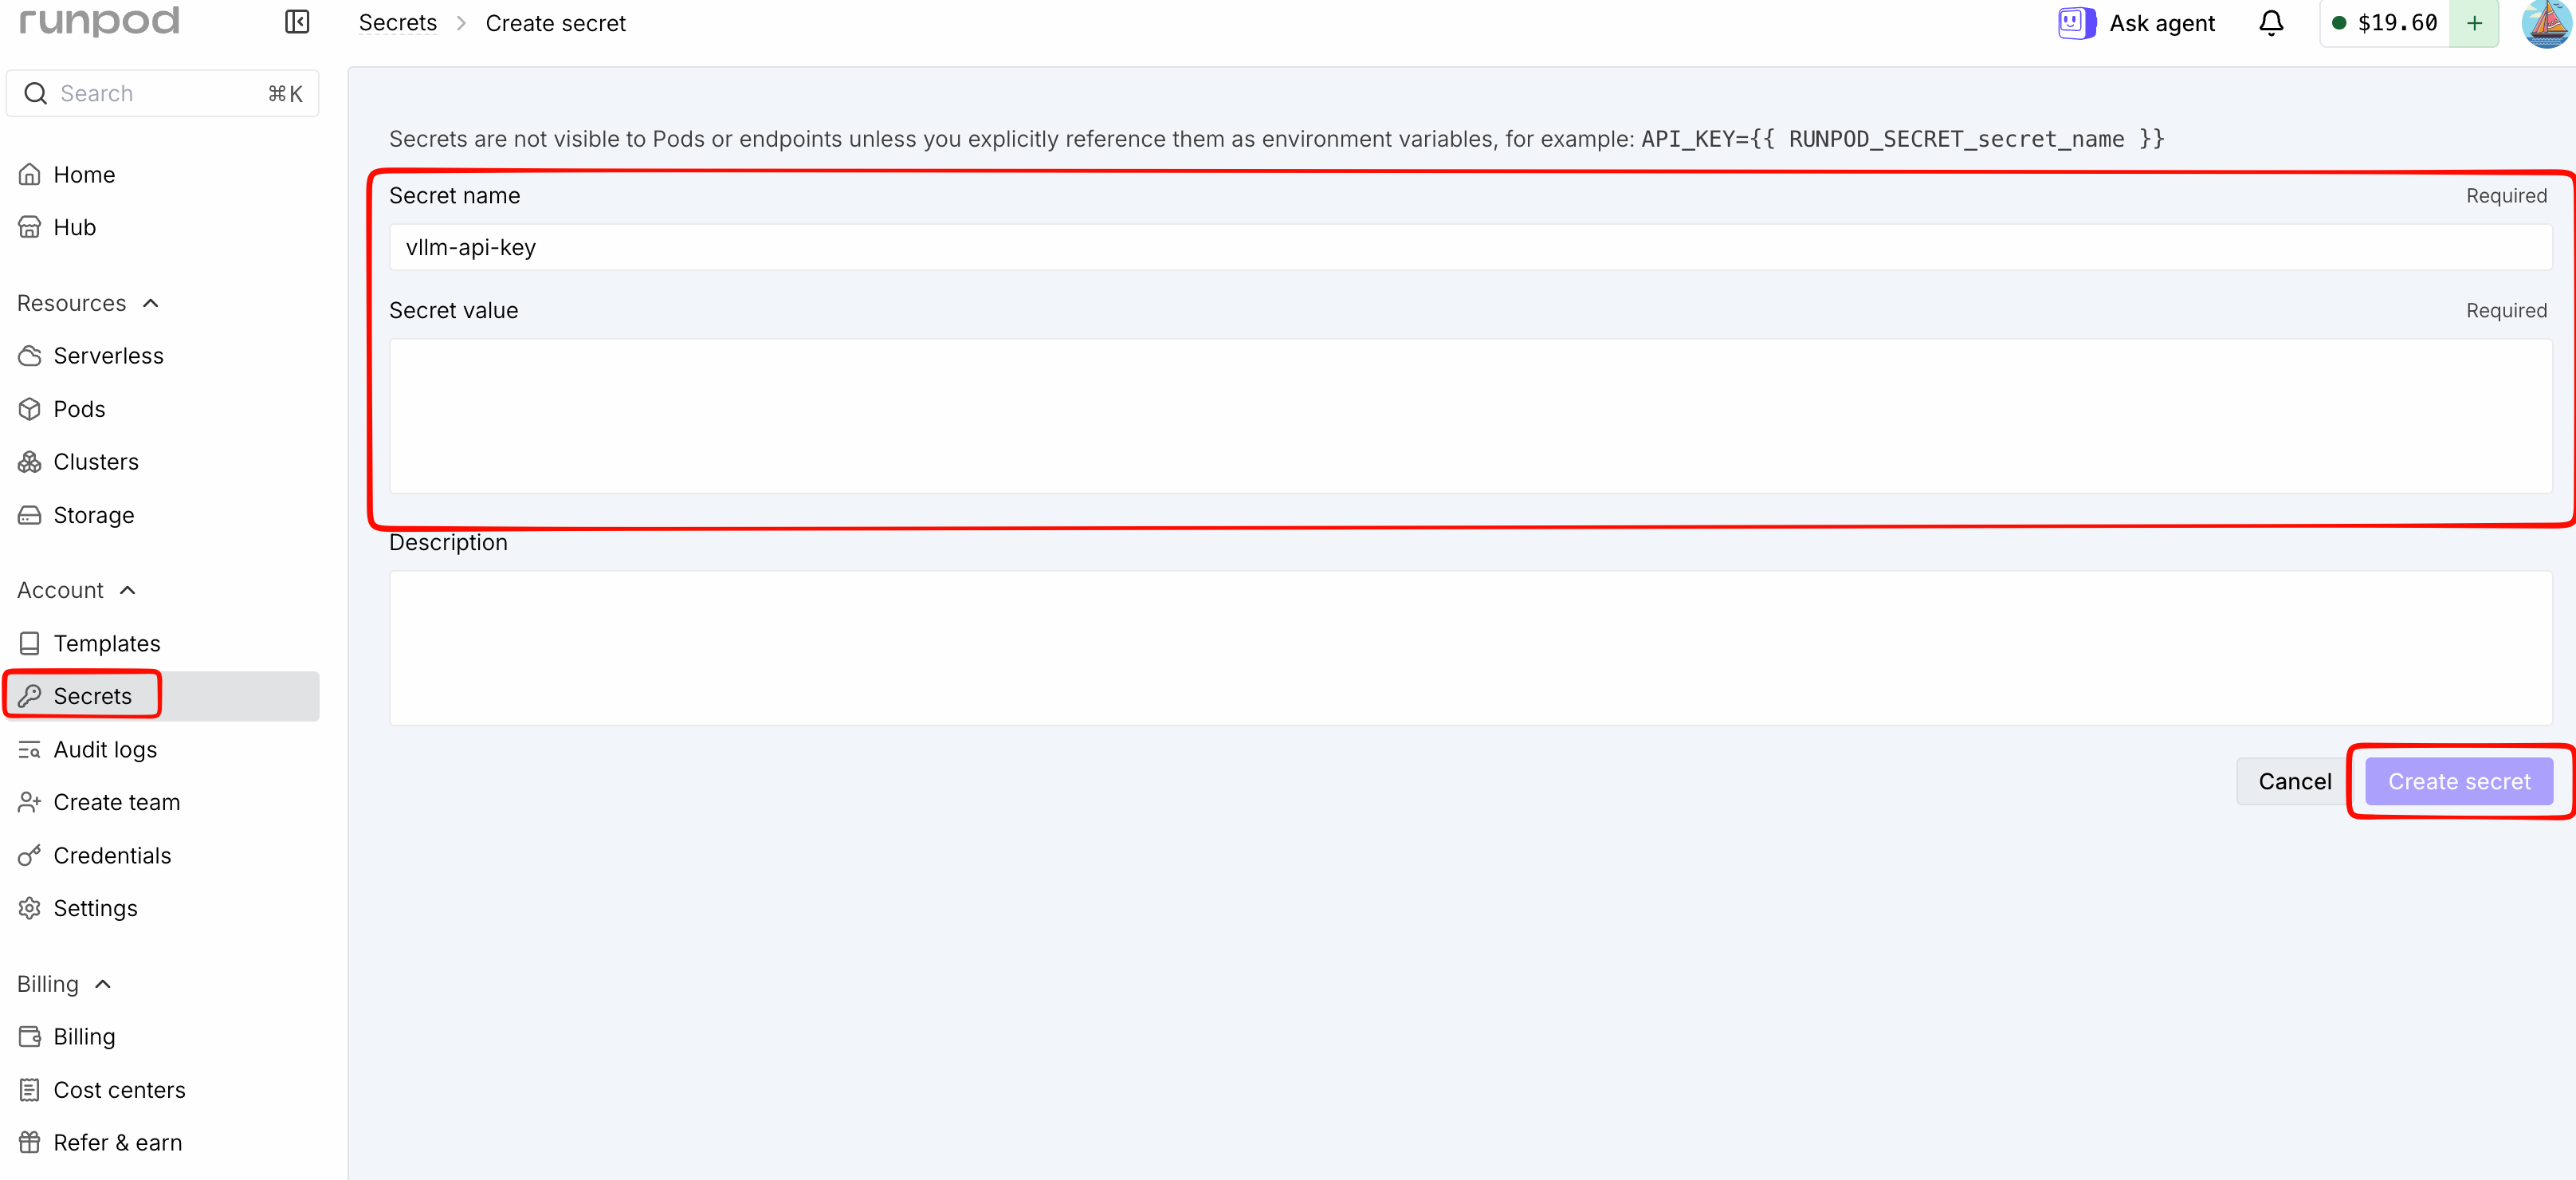
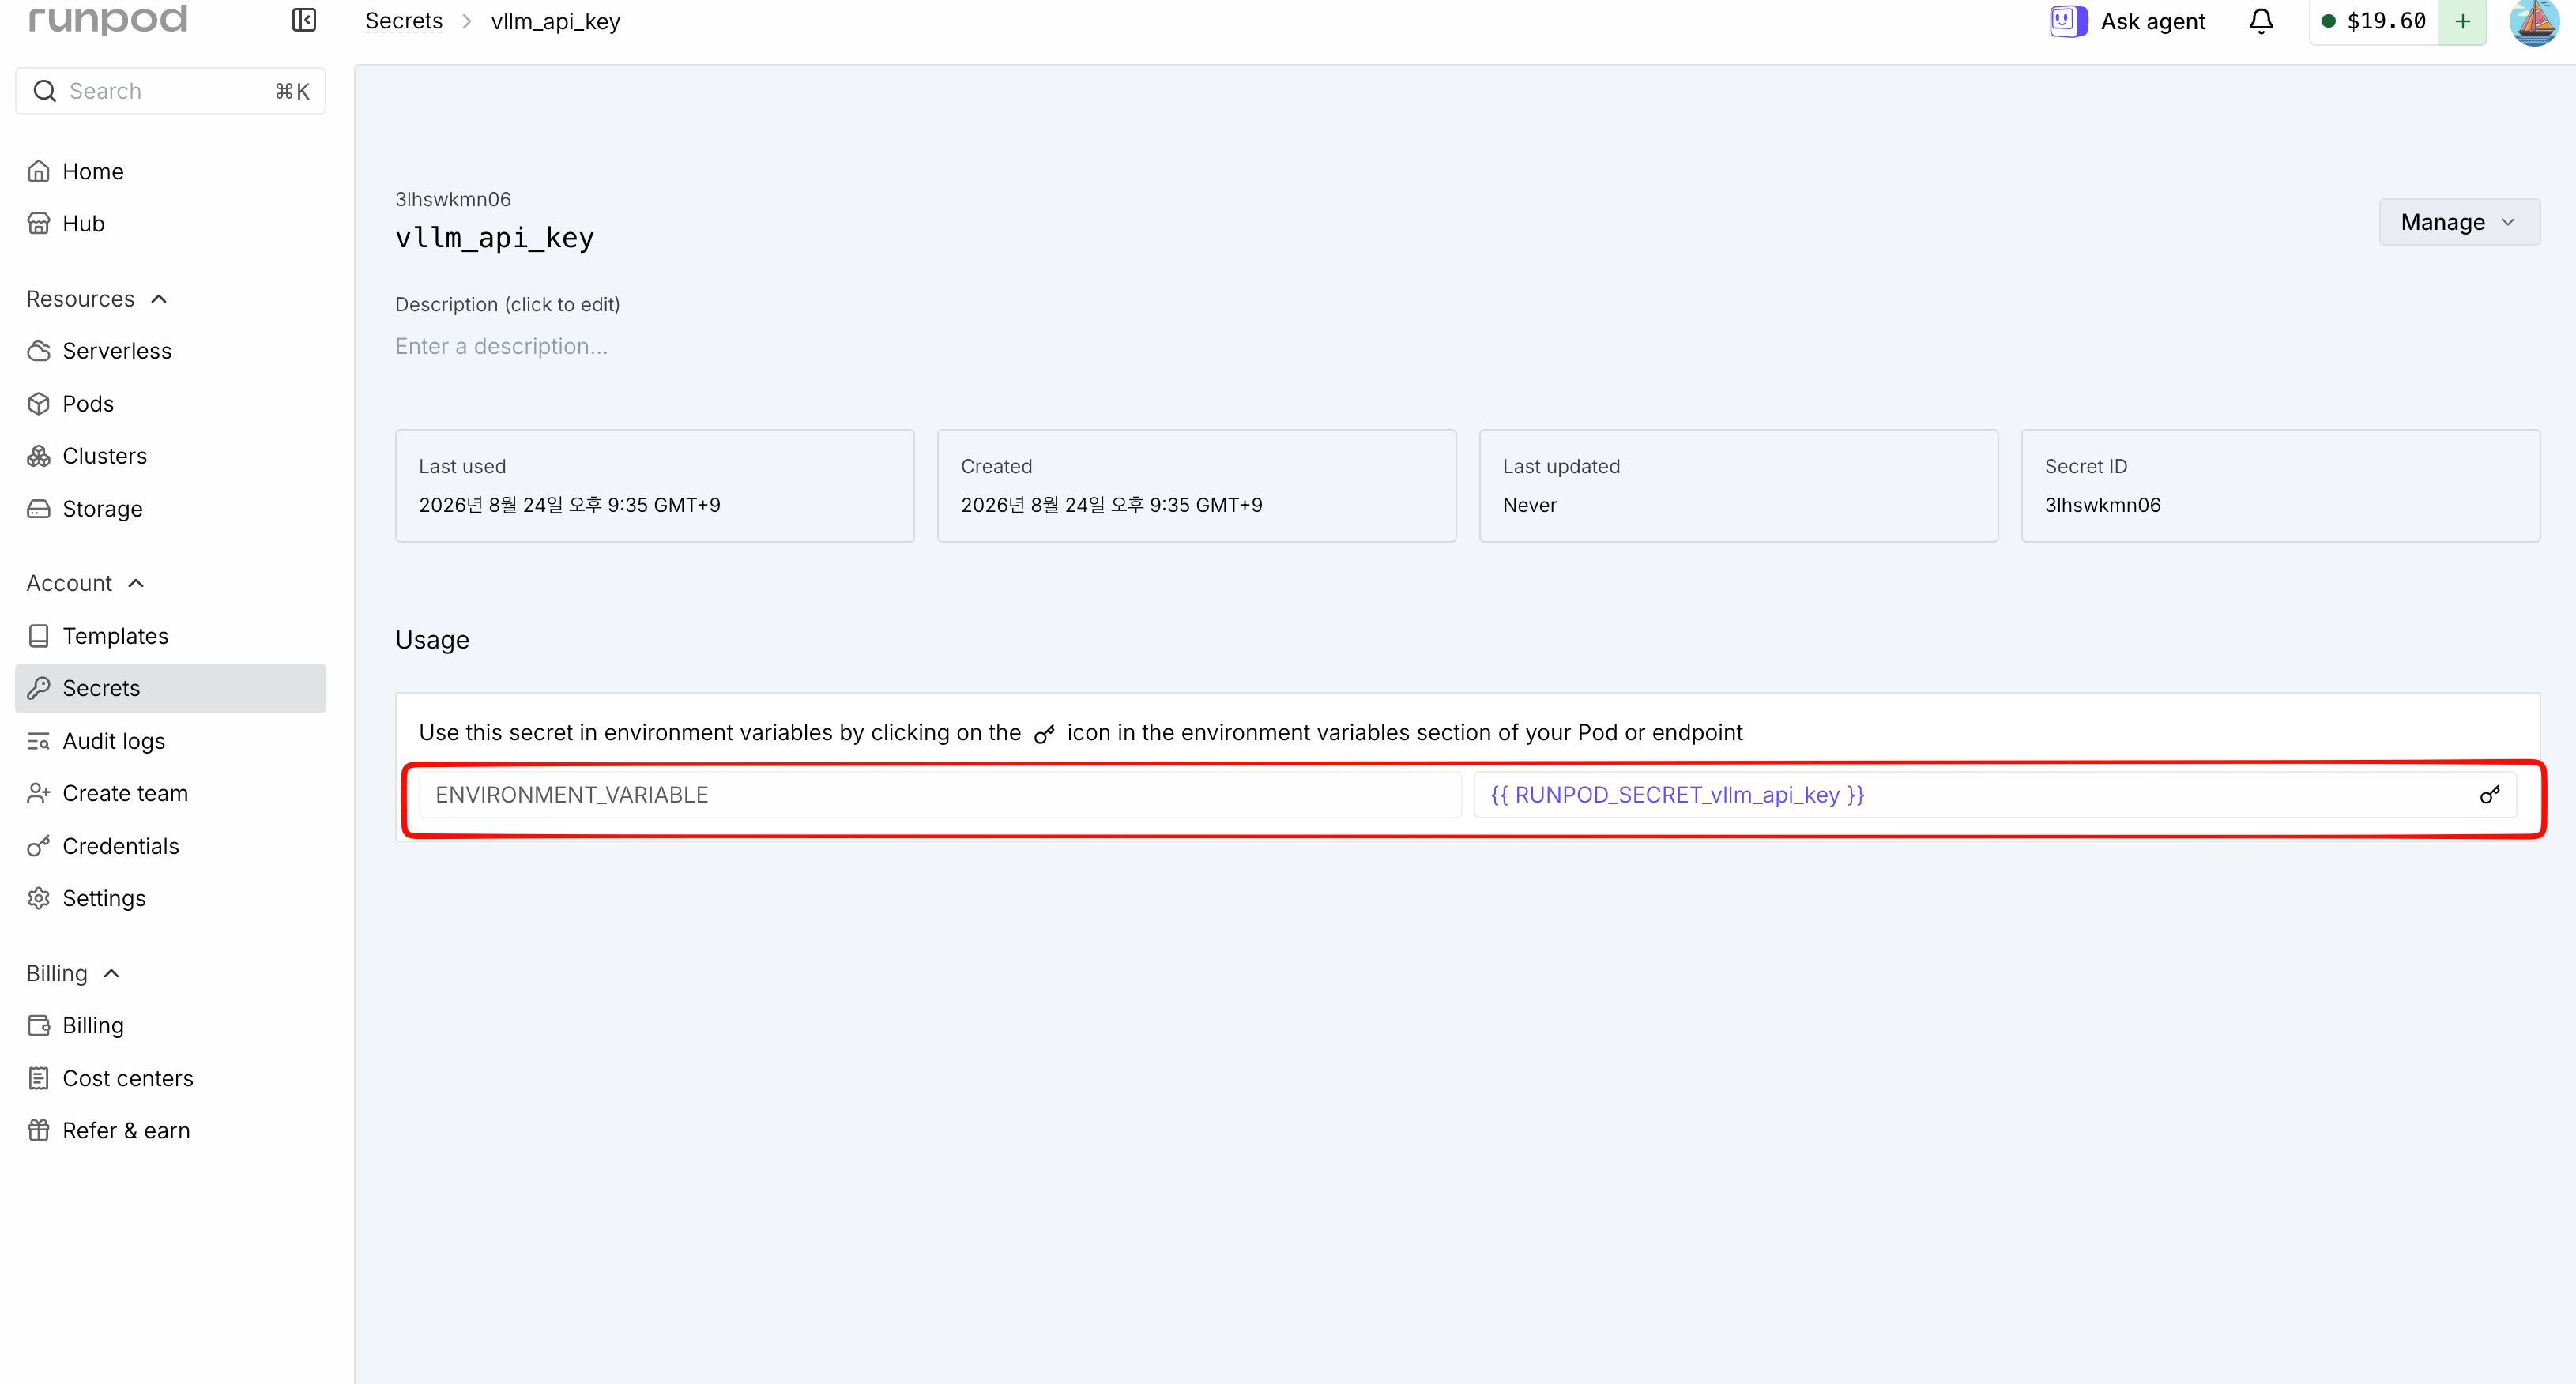
- 생성된 환경 변수 참조값을 복사하자. 나중에 컨테이너 파드에 환경변수를 주입할 것이다.
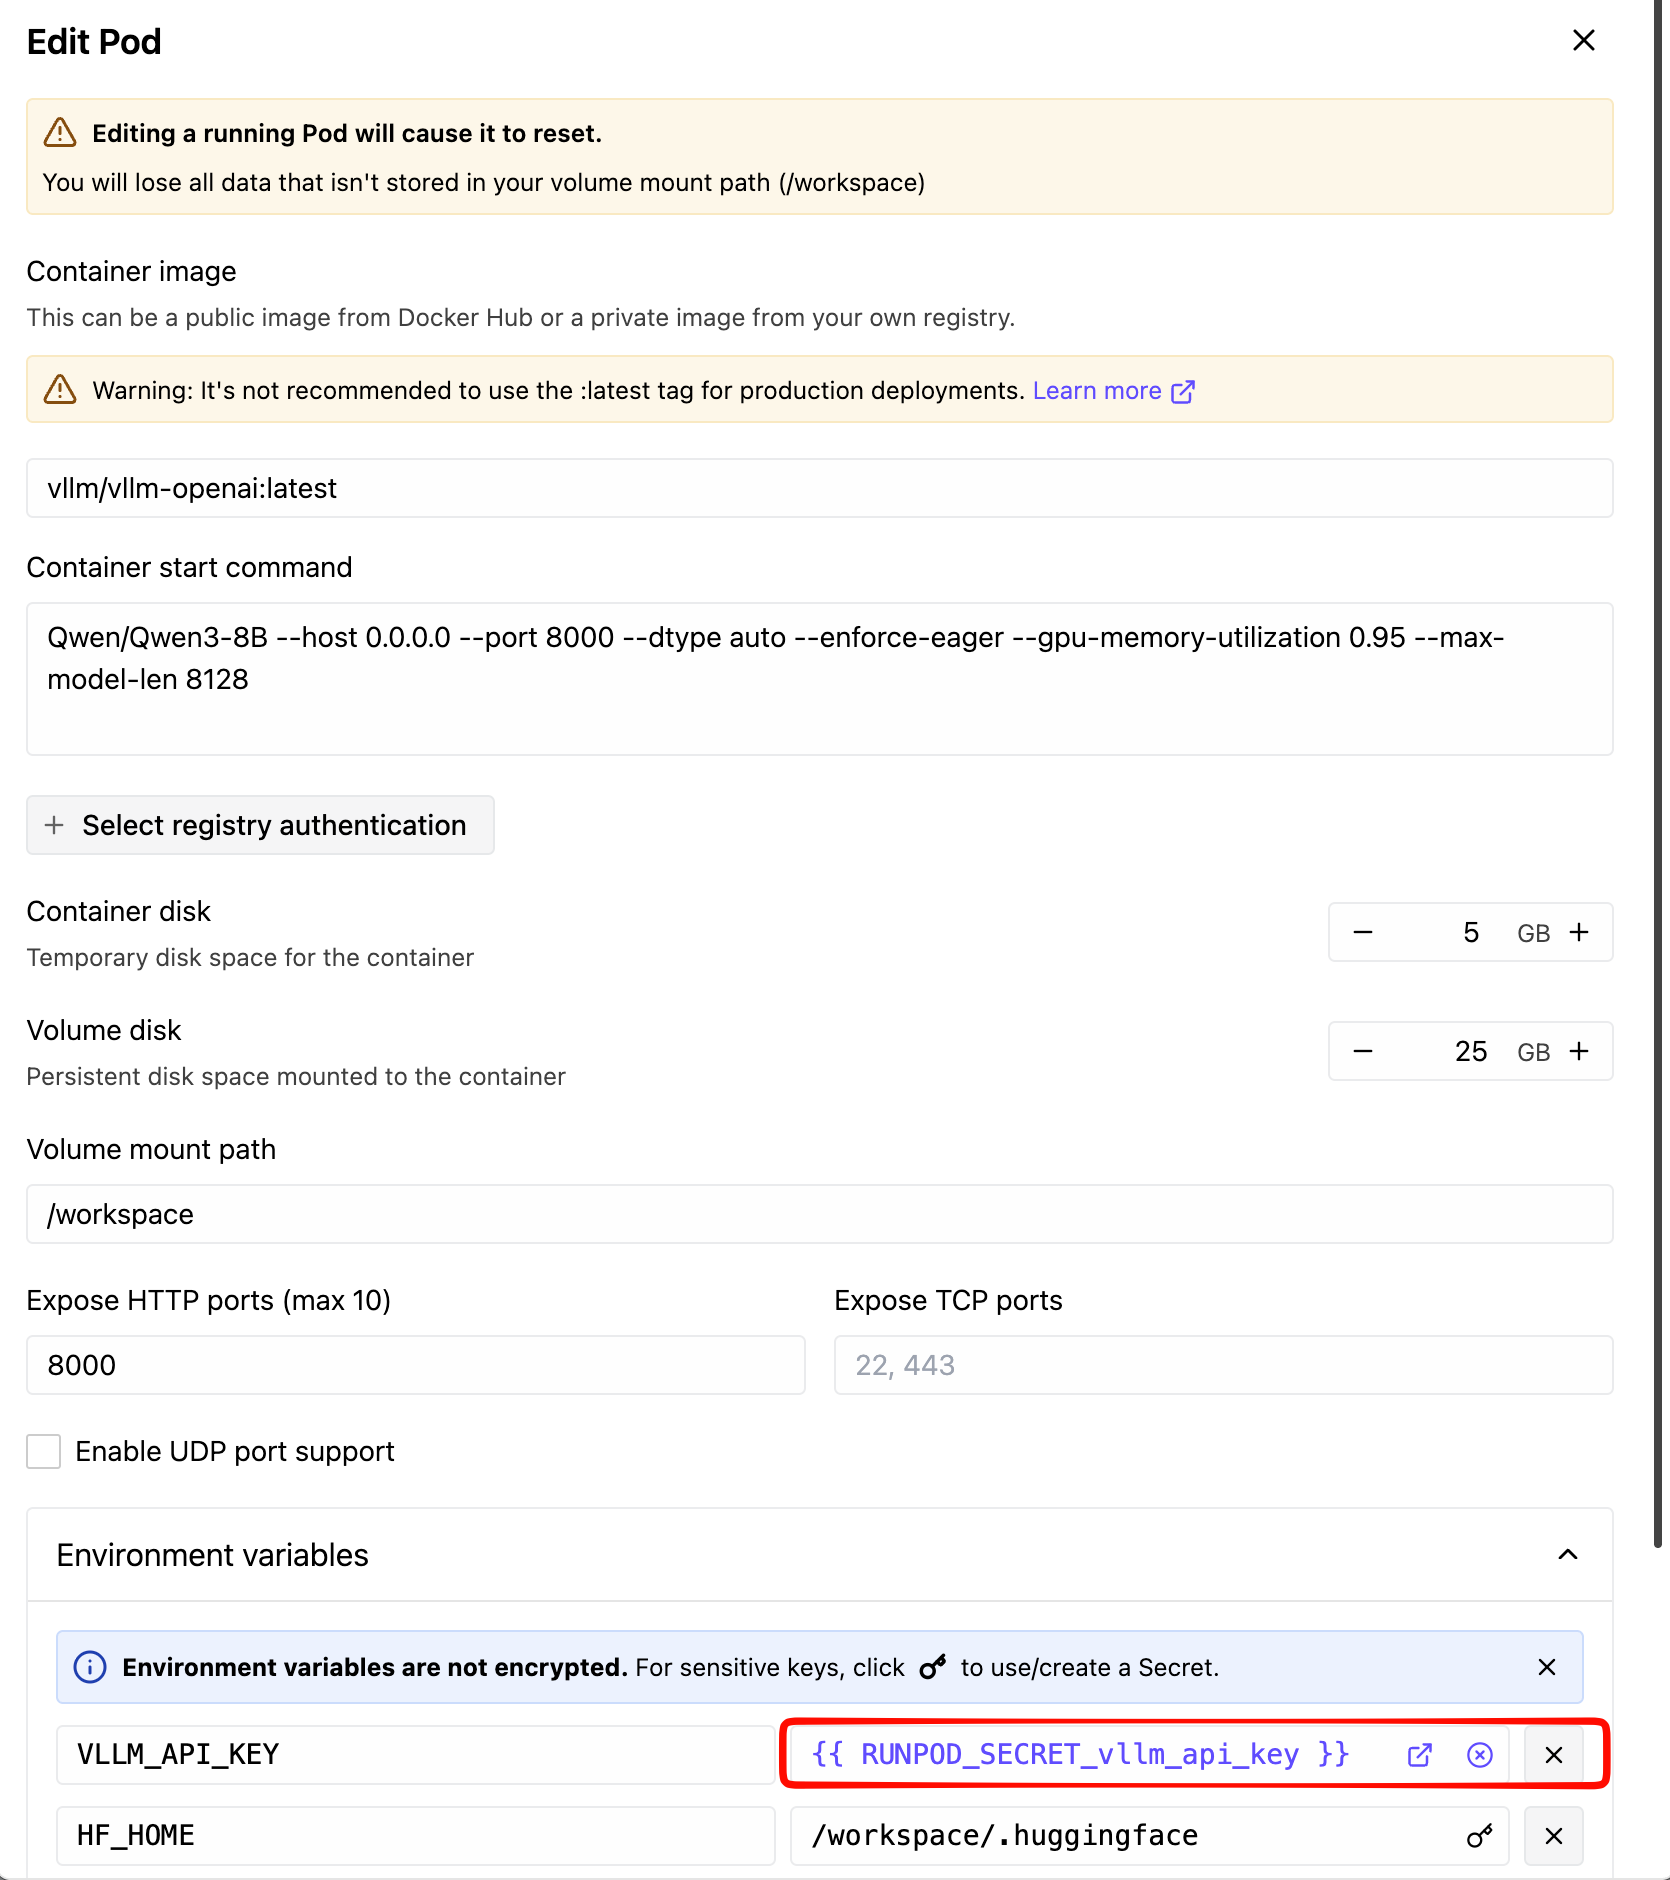
- 위에서 설정한 참조변수를 Pods의 Edit Pods를 클릭후 환경변수 VALUE에 넣어준다.
2. 접속 후 확인
nvidia-smi -L         # GPU 4개 잡히는지 먼저 확인
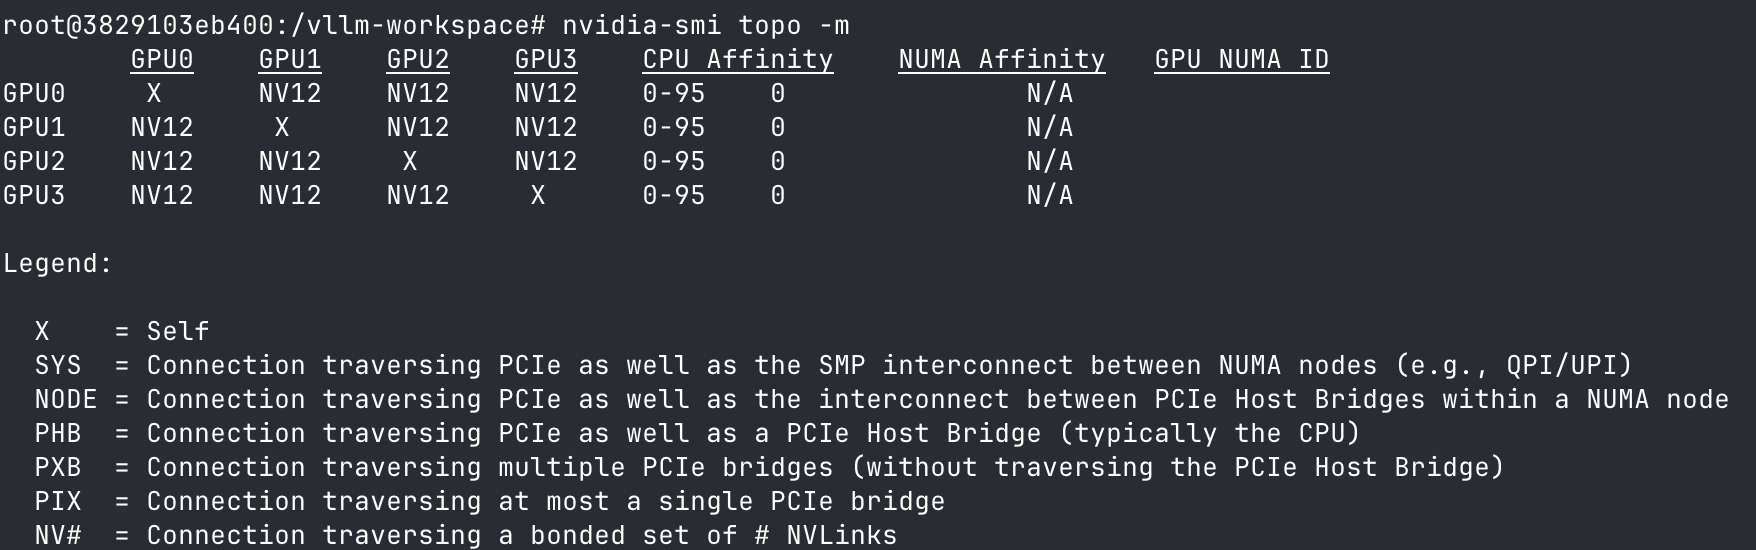
nvidia-smi topo -m    # GPU끼리 NV# 표시되면 NVLink 정상, PHB/PXB면 PCIe만 연결된 것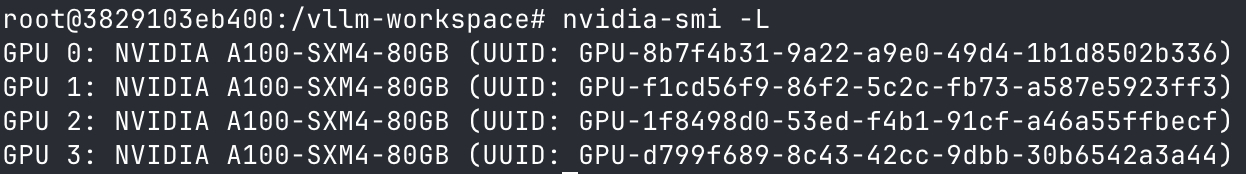
- GPU0부터 GPU3까지 NVLinks로 연결된것 확인
3. 서빙 실행
Pods에서 배포한 컨테이너의 맨 오른쪽 오버플로우 메뉴를 클릭후 Edit pod를 클릭한다.
3-1. TP=4
Runpod Edit Pod의 Container Start Command에 아래 인자를 그대로 붙여넣는다. vLLM Verified 템플릿은 ENTRYPOINT에 vllm serve가 이미 포함돼 있어서, 필드에는 모델 이름부터 시작하는 인자만 적으면 된다.
Qwen/Qwen3-8B --tensor-parallel-size 4 --host 0.0.0.0 --port 8000 --dtype auto --enforce-eager --gpu-memory-utilization 0.95 --max-model-len 8128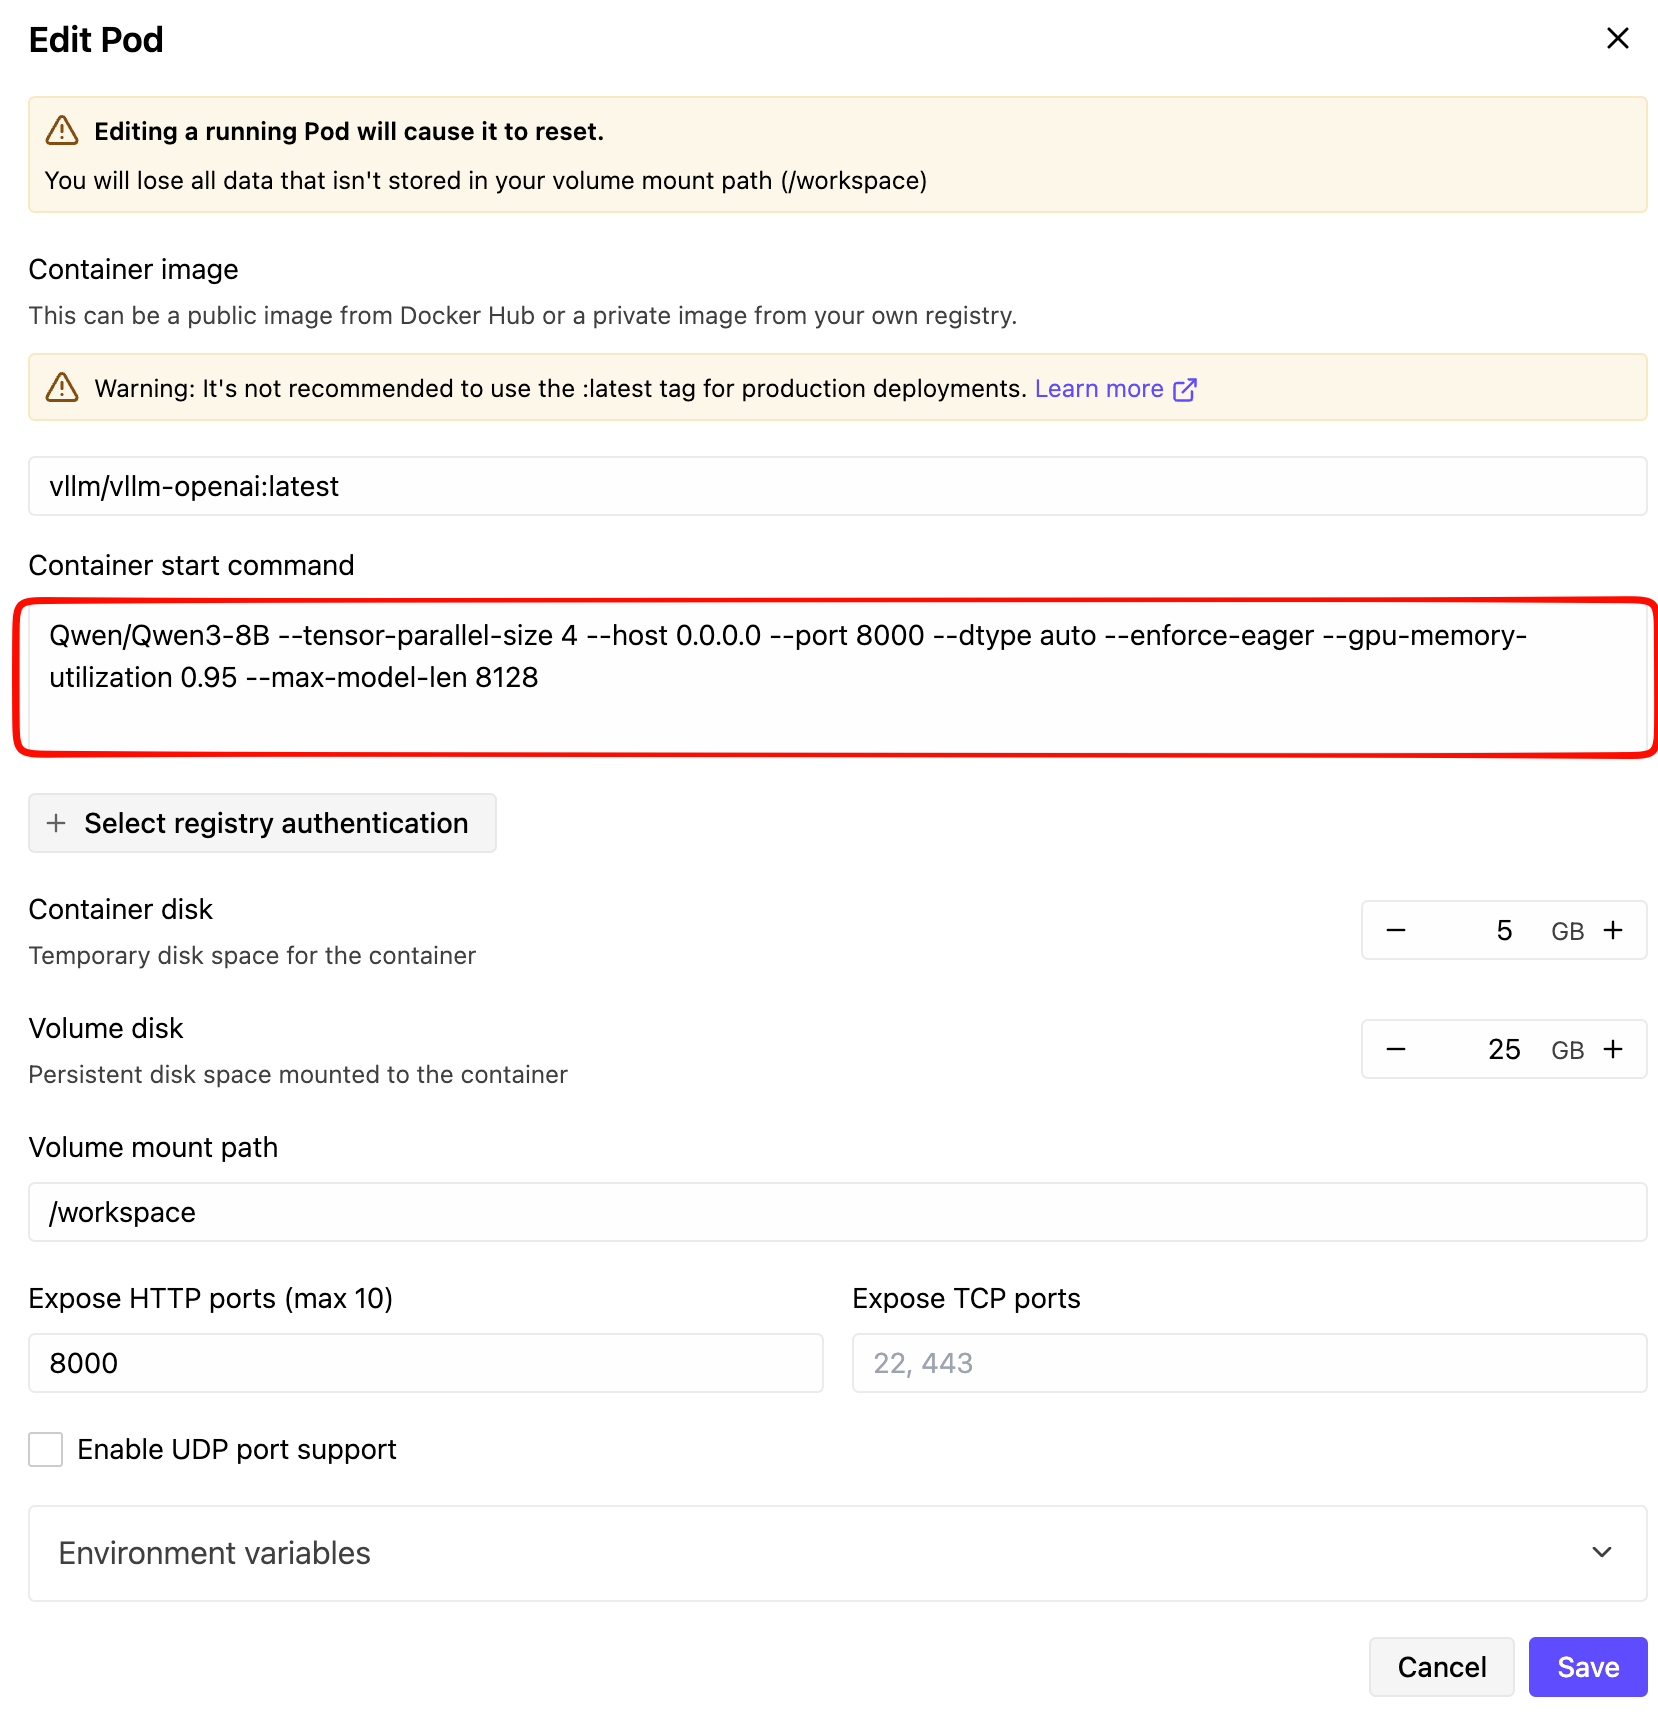
3-2. TP=2 × DP=2
Qwen/Qwen3-8B --tensor-parallel-size 2 --data-parallel-size 2 --host 0.0.0.0 --port 8000 --dtype auto --enforce-eager --gpu-memory-utilization 0.95 --max-model-len 81283-3. DP=4
Qwen/Qwen3-8B --tensor-parallel-size 1 --data-parallel-size 4 --host 0.0.0.0 --port 8000 --dtype auto --enforce-eager --gpu-memory-utilization 0.95 --max-model-len 8128편집 후에는 Pod를 재시작(Stop → Start, 또는 Edit 저장 시 자동 재시작)해야 새 커맨드가 적용된다. 모델을 바꿀 경우 attention head 수가 TP 크기로 나눠떨어지는지 미리 확인한다. 나눠떨어지지 않으면 “must be divisible” 에러가 뜬다.
4. 속도 측정
vllm bench serve \
  --backend vllm \
  --model Qwen/Qwen3-8B \
  --base-url http://localhost:8000 \
  --num-prompts 50 \
  --request-rate inf \
  --header "Authorization=Bearer $VLLM_API_KEY"
세 가지 구성(TP=4, TP=2×DP=2, DP=4) 각각에 대해 동시성 1(레이턴시 위주)과 동시성 높음(처리량 위주) 두 조건 모두 돌려서 비교한다. 나머지 조건(모델, 프롬프트 셋, --num-prompts)은 고정하고 서버 설정만 바꿔야 결과를 공정하게 비교할 수 있다.
측정 지표
- TTFT(Time To First Token) — prefill 성능 지표
- TPOT / ITL(Time Per Output Token / Inter-Token Latency) — decode 성능 지표
- Throughput — 초당 요청 수, 초당 생성 토큰 수
예상되는 대비 포인트
- TP=4: 4-way all-reduce라 통신은 가장 많지만, 모델이 가장 잘게 쪼개져 요청 하나당 TTFT가 가장 짧을 가능성
- TP=2 × DP=2: 통신 오버헤드는 절반(2-way all-reduce)으로 줄고, 두 개의 복제본이 요청을 나눠 처리해 처리량이 유리해질 가능성
- DP=4: 추론 시 DP는 복제본 간 통신이 전혀 없으므로(0 byte), 개별 요청 레이턴시는 TP=1 그대로지만 동시 처리량은 가장 높을 가능성
“TP 비중을 낮추고 DP 비중을 높일수록 레이턴시는 손해 보고 처리량은 이득 본다"는 트레이드오프 곡선을 4장짜리 GPU만으로도 확인한다.
5. 실측 결과
A100 이전에 처음 잡은 Runpod Pod는 4x L40S(PCIe, NVLink 없음)였는데 이 호스트에서 NCCL P2P 핸드셰이크가 멈추는 문제가 있어 NCCL_P2P_DISABLE=1을 추가해 우회했다. 이후 두 번째 Pod는 4x A100 SXM으로, nvidia-smi topo -m 확인 결과 GPU 전 쌍이 NV12로 연결되어 실제 NVLink가 동작했다. 이 pod에서는 NCCL_P2P_DISABLE을 제거하고 재측정하였다.
명령
vllm bench serve \
  --backend vllm \
  --model Qwen/Qwen3-8B \
  --base-url http://localhost:8000 \
  --num-prompts 50 \
  --request-rate inf \
  --header "Authorization=Bearer $VLLM_API_KEY"
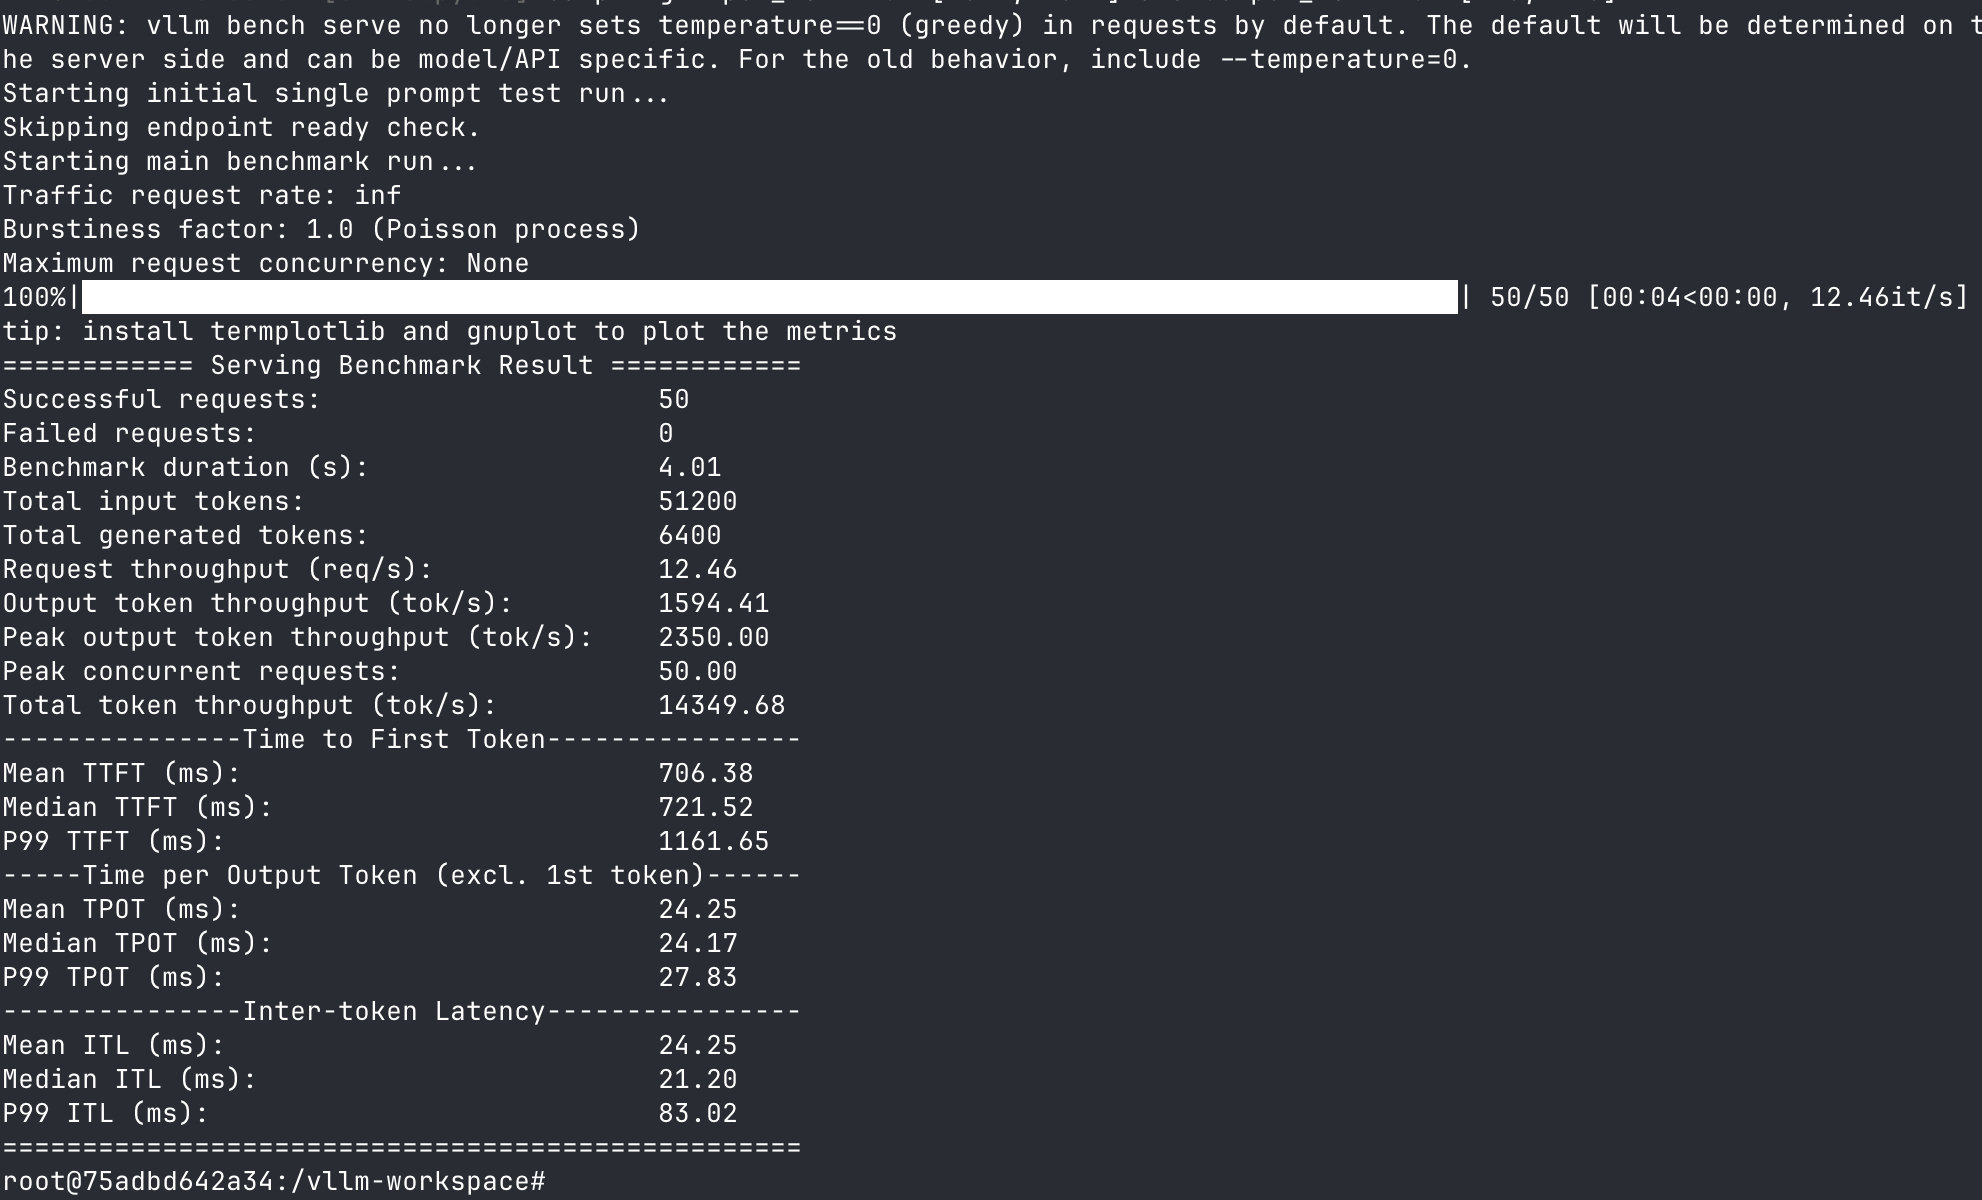
성공하면 먼저 아래와 같은 결과를 얻을 수 있다.
결과 한눈에 비교
- 결과 (요청 50개, 동시성 최대)
| 지표 | TP=4 (L40S, PCIe) | TP=4 (A100 SXM, Qwen3-8B) | TP=2×DP=2 (A100 SXM, Qwen3-8B) | DP=4 (A100 SXM, Qwen3-8B) | TP=4 (A100 SXM, Qwen2.5-72B) | TP=2×DP=2 (A100 SXM, Qwen2.5-72B) | TP=4 (A100 SXM, Qwen3-14B) | TP=2×DP=2 (A100 SXM, Qwen3-14B) | DP=4 (A100 SXM, Qwen3-14B) |
|---|---|---|---|---|---|---|---|---|---|
| Successful / Failed | 50 / 0 | 50 / 0 | 50 / 0 | 50 / 0 | 50 / 0 | 50 / 0 | 50 / 0 | 50 / 0 | 50 / 0 |
| Benchmark duration | 6.08s | 4.34s | 4.01s | 3.24s | 14.49s | 15.61s | 5.89s | 5.22s | 4.43s |
| Request throughput | 8.23 req/s | 11.53 req/s | 12.46 req/s | 15.41 req/s | 3.45 req/s | 3.20 req/s | 8.49 req/s | 9.58 req/s | 11.29 req/s |
| Output token throughput | 1,052.99 tok/s | 1,475.59 tok/s | 1,594.41 tok/s | 1,972.70 tok/s | 441.55 tok/s | 410.12 tok/s | 1,086.76 tok/s | 1,226.62 tok/s | 1,445.66 tok/s |
| Peak output token throughput | 2,717.00 tok/s | 2,250.00 tok/s | 2,350.00 tok/s | 2,851.00 tok/s | 1,150.00 tok/s | 850.00 tok/s | 1,800.00 tok/s | 2,058.00 tok/s | 2,250.00 tok/s |
| Total token throughput | 9,476.87 tok/s | 13,280.32 tok/s | 14,349.68 tok/s | 17,754.27 tok/s | 3,973.93 tok/s | 3,691.06 tok/s | 9,780.86 tok/s | 11,039.57 tok/s | 13,010.98 tok/s |
| Mean TTFT | 2,053.43 ms | 831.52 ms | 706.38 ms | 605.67 ms | 4,796.50 ms | 4,488.11 ms | 1,291.49 ms | 1,094.67 ms | 1,006.66 ms |
| Median TTFT | 2,052.03 ms | 831.12 ms | 721.52 ms | 643.24 ms | 4,789.68 ms | 4,644.79 ms | 1,291.18 ms | 1,104.89 ms | 1,110.72 ms |
| P99 TTFT | 3,784.41 ms | 1,485.30 ms | 1,161.65 ms | 945.33 ms | 8,939.45 ms | 7,819.13 ms | 2,319.03 ms | 1,839.10 ms | 1,586.65 ms |
| Mean TPOT | 30.11 ms | 25.53 ms | 24.25 ms | 19.59 ms | 72.04 ms | 84.62 ms | 33.49 ms | 30.96 ms | 25.87 ms |
| Mean ITL | 30.11 ms | 25.53 ms | 24.25 ms | 19.59 ms | 72.04 ms | 84.62 ms | 33.49 ms | 30.96 ms | 25.87 ms |
| Median ITL | 18.38 ms | 22.68 ms | 21.20 ms | 17.34 ms | 43.37 ms | 61.59 ms | 27.58 ms | 24.88 ms | 22.23 ms |
| P99 ITL | 146.51 ms | 56.01 ms | 83.02 ms | 126.87 ms | 352.62 ms | 610.64 ms | 89.03 ms | 135.43 ms | 221.29 ms |
(Total input tokens 51,200 / Total generated tokens 6,400은 네 구성 모두 동일 — 같은 프롬프트 셋을 썼기 때문)
Qwen2.5-72B는 DP=4(
tensor-parallel-size 1 --data-parallel-size 4) 구성을 시도하지 않았다. DP는 모델을 쪼개지 않고 GPU마다 전체 모델을 복제하는 방식이라, bf16 기준 약 144GB인 72B 모델을 80GB A100 한 장에 올려야 한다. 실제로 시도하면torch.OutOfMemoryError로 즉시 실패하며, Pod를 재시작해도 동일하게 실패한다 — 잔여 메모리 문제가 아니라 GPU 용량을 넘어서는 구조적 한계다.
고찰 (어디까지나 실측치 기준)
1. NVLink 효과가 뚜렷하다
같은 TP=4 구성에서 L40S(PCIe) → A100 SXM(NVLink)로 바꾸자 Mean TTFT가 2,053ms → 832ms로 약 2.5배 줄었다. TP=4는 레이어마다 4-way all-reduce가 필요해 인터커넥트 차이가 그대로 드러난다. 다만 두 GPU는 스펙 자체도 달라 이 차이가 순수하게 인터커넥트 때문만은 아니다.
2. TP=2×DP=2가 TP=4보다 낫다 — Qwen3-8B 기준
예상과 달리 같은 A100 SXM 환경에서 TP=2×DP=2가 TP=4보다 TTFT(706ms vs 832ms)와 처리량(12.46 vs 11.53 req/s) 모두 앞선다. 통신량이 절반으로 줄어드는 이득과, 두 replica가 요청을 나눠 처리하는 이득이 합쳐진 결과로 보인다.
3. GPU 한 장에 들어가는 모델은 DP가 유리하다
Qwen3-8B·14B처럼 GPU 한 장(80GB)에 여유 있게 들어가는 모델은 TP=4 → TP=2×DP=2 → DP=4로 갈수록 모든 지표가 일관되게 개선된다. 메모리가 부족하지 않은 이상 TP는 all-reduce 통신 오버헤드만 추가할 뿐 이득을 주지 못한것같다.
4. GPU 한 장에 안 들어가는 모델은 TP가 필수다
Qwen2.5-72B(bf16 약 144GB)는 반대로 TP=4가 TP=2×DP=2보다 처리량(3.45 vs 3.20 req/s)과 TPOT(72.04 vs 84.62ms)에서 앞섰고, DP=4는 당연 단일 GPU의 VRAM부족으로 시도조차 불가능했다. 모델이 GPU 한 장에 들어가는지 여부가 TP/DP 비중을 정하는 1차 기준일 것이다.
TTFT가 전반적으로 수백 ms~2초대로 나온 건 --request-rate inf로 50개 요청이 한 번에 몰려서 prefill 큐가 밀린 영향이 크다. 개별 요청의 최선 레이턴시가 아니라 최대 부하 상태의 처리량 지표로 봐야 한다.